library(ape)
library(phytools)
library(geiger)
library(corHMM)Roteiro prático — Atributos discretos
Aula 6 · Métodos Filogenéticos Comparativos
0. Pacotes
1. Da taxa à probabilidade: P(t) = eQt
A matriz Q guarda as taxas instantâneas; cada linha soma zero. A exponencial de matriz dá as probabilidades de transição ao longo de um ramo de comprimento t. Com q01 = q10 = 0,1 e t = 5 (o exemplo dos slides):
Q <- matrix(c(-0.1, 0.1,
               0.1, -0.1), 2, byrow = TRUE, dimnames = list(c("0", "1"), c("0", "1")))
rowSums(Q)
0 1
0 0 Pt <- matexpo(Q * 5)
dimnames(Pt) <- dimnames(Q)
round(Pt, 3) 0 1
0 0.684 0.316
1 0.316 0.684Cada linha de P(t) soma 1. Ao longo do tempo, as probabilidades convergem para as frequências de equilíbrio:
tt <- seq(0, 30, by = 0.5)
p11 <- sapply(tt, \(t) matexpo(Q * t)[2, 2])
plot(tt, p11, type = "l", ylim = c(0, 1), xlab = "tempo", ylab = "P(continuar no estado 1)")
abline(h = 0.5, lty = 2); abline(v = 5, lty = 3)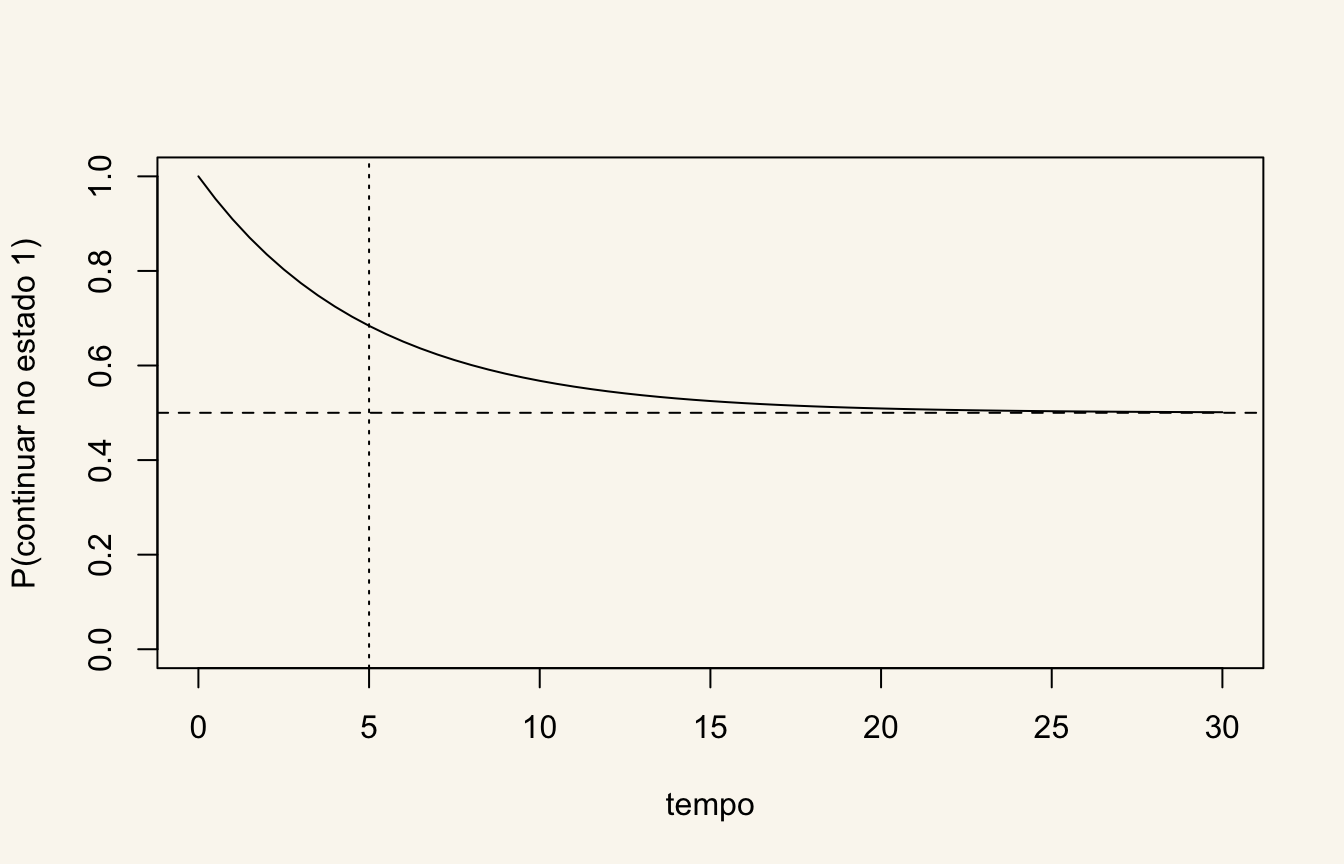
2. Dados reais: a perda dos membros nos Squamata
Os dados de Brandley, Huelsenbeck & Wiens (2008). Uma espécie é “sem membros” se não tem nem os anteriores (FLL = 0) nem os posteriores (HLL = 0).
d <- read.csv("brandley_table.csv")
arv <- read.nexus("squamate.tre")
sp <- sub(" ", "_", d$Species)
membros <- setNames(ifelse(d$FLL == 0 & d$HLL == 0, "sem", "com"), sp)
casado <- treedata(arv, membros, warnings = FALSE)
arv <- casado$phy
membros <- membros[arv$tip.label]
table(membros)
membros
com sem
207 51 Taxas iguais (ER) e taxas diferentes nos dois sentidos (ARD), com o fitDiscrete():
er  <- fitDiscrete(arv, membros, model = "ER")
ard <- fitDiscrete(arv, membros, model = "ARD")
er$opt[c("lnL", "q12", "aicc")]
$lnL
[1] -80.48718
$q12
[1] 0.001850204
$aicc
[1] 162.99ard$opt[c("lnL", "q12", "q21", "aicc")]$lnL
[1] -79.38381
$q12
[1] 0.001610641
$q21
[1] 0.003824775
$aicc
[1] 162.8147As taxas seguem a ordem alfabética dos estados (com, sem): q12 é com → sem (perda) e q21 é sem → com (reganho). A diferença de AICc é pequena: os dados não distinguem os dois modelos.
O phytools::fitMk() ajusta o mesmo modelo, mas com outra suposição sobre o estado da raiz, e por isso dá log L um pouco diferente:
fitMk(arv, membros, model = "ER")$logLik[1] -81.110773. Simulando o Mk
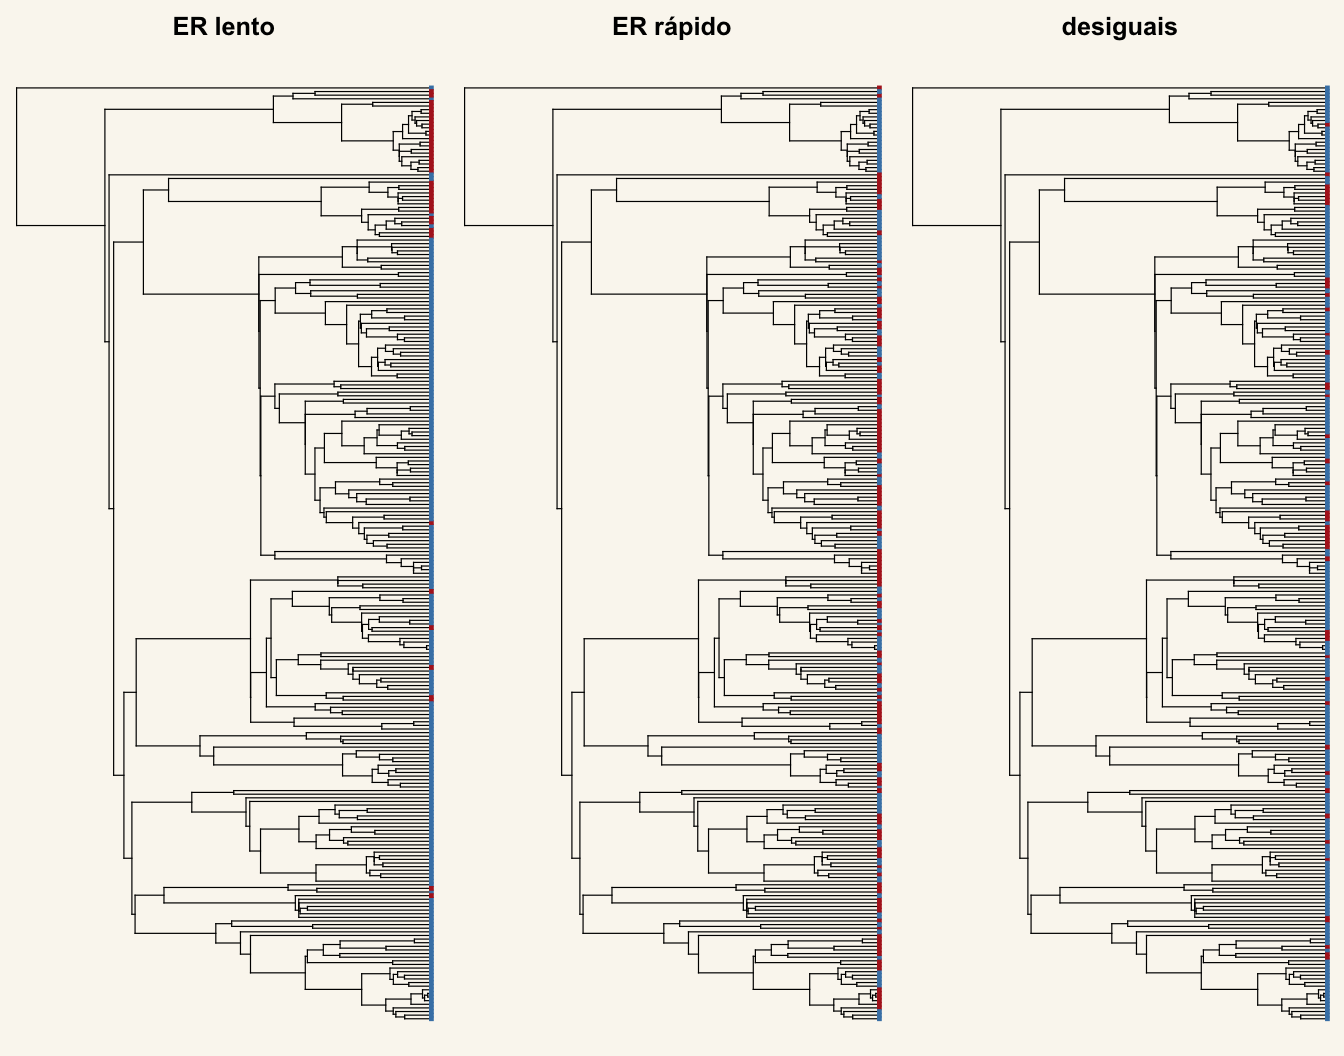
O mesmo modelo, simulado na árvore dos Squamata com taxas lentas, rápidas e desiguais (como nos slides):
h <- max(nodeHeights(arv))
Qm <- function(a, b) matrix(c(-a, a, b, -b), 2, byrow = TRUE,
                            dimnames = list(c("com", "sem"), c("com", "sem")))
set.seed(601)
sims <- list("ER lento" = Qm(0.2 / h, 0.2 / h), "ER rápido" = Qm(5 / h, 5 / h),
             "desiguais" = Qm(1 / h, 4 / h))
par(mfrow = c(1, 3))
for (nm in names(sims)) {
  x <- sim.Mk(arv, sims[[nm]], anc = "com")
  plotTree(arv, ftype = "off", lwd = 0.6, mar = c(0, 0, 2, 0))
  title(nm)
  tiplabels(pch = 15, cex = 0.5, col = ifelse(x[arv$tip.label] == "sem", "firebrick", "steelblue"))
}
4. Caracteres multiestado
Quatro estados: sem membros, só anteriores, só posteriores e os quatro.
q4 <- setNames(ifelse(d$FLL == 0 & d$HLL == 0, "sem membros",
               ifelse(d$FLL > 0 & d$HLL == 0, "só anteriores",
               ifelse(d$FLL == 0 & d$HLL > 0, "só posteriores", "os quatro"))), sp)[arv$tip.label]
table(q4)
q4
os quatro sem membros só anteriores só posteriores
163 51 3 41 m4 <- lapply(c(ER = "ER", SYM = "SYM", ARD = "ARD"), \(m) fitDiscrete(arv, q4, model = m))
tab4 <- data.frame(modelo = names(m4), k = sapply(m4, \(f) f$opt$k),
logL = sapply(m4, \(f) f$opt$lnL), AICc = sapply(m4, \(f) f$opt$aicc))
tab4$peso <- exp(-0.5 * (tab4$AICc - min(tab4$AICc))); tab4$peso <- tab4$peso / sum(tab4$peso)
tab4 modelo k logL AICc peso
ER ER 1 -137.1870 276.3895 0.0006118476
SYM SYM 6 -124.6883 261.7112 0.9418937242
ARD ARD 12 -121.0151 267.3036 0.05749442825. Taxas ocultas
E se a taxa de perda dos membros variar entre clados? O corHMM() divide cada estado observado em categorias de taxa não observadas (rate.cat).
dados_hmm <- data.frame(sp = names(membros), membros = membros)
set.seed(604)   # o corHMM sorteia pontos de partida
invisible(capture.output({   # o corHMM imprime mensagens de progresso
  hmm1 <- corHMM(arv, dados_hmm, rate.cat = 1, model = "ARD", node.states = "none")
  hmm2 <- corHMM(arv, dados_hmm, rate.cat = 2, model = "ARD", node.states = "none")
}))
c(uma_categoria = hmm1$AICc, duas_categorias = hmm2$AICc)
uma_categoria duas_categorias
163.1873 169.0454 O modelo com duas categorias tem o dobro de parâmetros e AICc 5,9 unidades maior: os dados não sustentam taxas de perda e reganho dos membros diferentes entre clados, e uma única categoria basta. Isso não prova que a taxa seja constante, só que esta árvore e este caráter não dão informação para estimar a variação.
6. Evolução correlacionada: Pagel e as taxas ocultas
Dois caracteres binários da prática (x com estados a/b; y com 0/1). Primeiro o teste de Pagel: um modelo independente contra um dependente.
X <- read.csv("fitPagel-data.csv", row.names = 1)
arv_p <- read.tree("fitPagel-tree.tre")
x <- setNames(X$x, rownames(X)); y <- setNames(as.character(X$y), rownames(X))
pg <- fitPagel(arv_p, x, y)
pg
Pagel's binary character correlation test:

Assumes "ARD" substitution model for both characters

Independent model rate matrix:
          a|a       a|b       b|a       b|b
a|a -1.633877  0.792916  0.840961  0.000000
a|b  0.459590 -1.300550  0.000000  0.840961
b|a  0.594017  0.000000 -1.386933  0.792916
b|b  0.000000  0.594017  0.459590 -1.053607

Dependent (x & y) model rate matrix:
          a|a       a|b       b|a       b|b
a|a -1.066808  0.653804  0.413004  0.000000
a|b  0.909423 -4.681912  0.000000  3.772489
b|a  2.606484  0.000000 -4.211865  1.605381
b|b  0.000000  0.362444  0.344054 -0.706498

Model fit:
            log-likelihood      AIC
independent      -233.0357 474.0715
dependent        -206.5951 429.1903

Hypothesis test result:
  likelihood-ratio:  52.8812
  p-value:  9.0237e-11

Model fitting method used was fitMk

R thinks both model optimizations converged.
O problema (slides): uma mudança única e não replicada pode bastar para o modelo dependente vencer. A saída de Boyko & Beaulieu (2023) é pôr taxas ocultas também no modelo independente e comparar os quatro modelos. (Leva alguns minutos.)
set.seed(1)   # com as sementes 1 a 4, o mesmo resultado dos slides
invisible(capture.output(
  teste <- fitCorrelationTest(arv_p, data.frame(sp = rownames(X), x = X$x, y = X$y))
))
aicc <- sapply(teste, \(f) f$AICc)
peso <- exp(-0.5 * (aicc - min(aicc))); peso <- peso / sum(peso)
round(data.frame(AICc = aicc, peso = peso), 3)
AICc peso
independent_model_fit 474.912 0.000
hidden_Markov_independent_model_fit 433.827 0.164
correlated_model_fit 430.574 0.836
hidden_Markov_correlated_model_fit 448.668 0.000O modelo independente com taxas ocultas fica perto do correlacionado: o apoio à correlação é bem mais modesto do que o valor-p do teste de Pagel sugeria.
7. O modelo de limiar
Um estado discreto como o lado de um limiar de um atributo contínuo não observado (a liability), que evolui por BM:
set.seed(603)
arv20 <- pbtree(n = 40, scale = 1)
liab <- fastBM(arv20, internal = TRUE)
estado <- ifelse(liab[1:40] > 0, "1", "0")
phenogram(arv20, liab, ftype = "off", ylab = "liability", xlab = "tempo")
abline(h = 0, lwd = 2, lty = 2)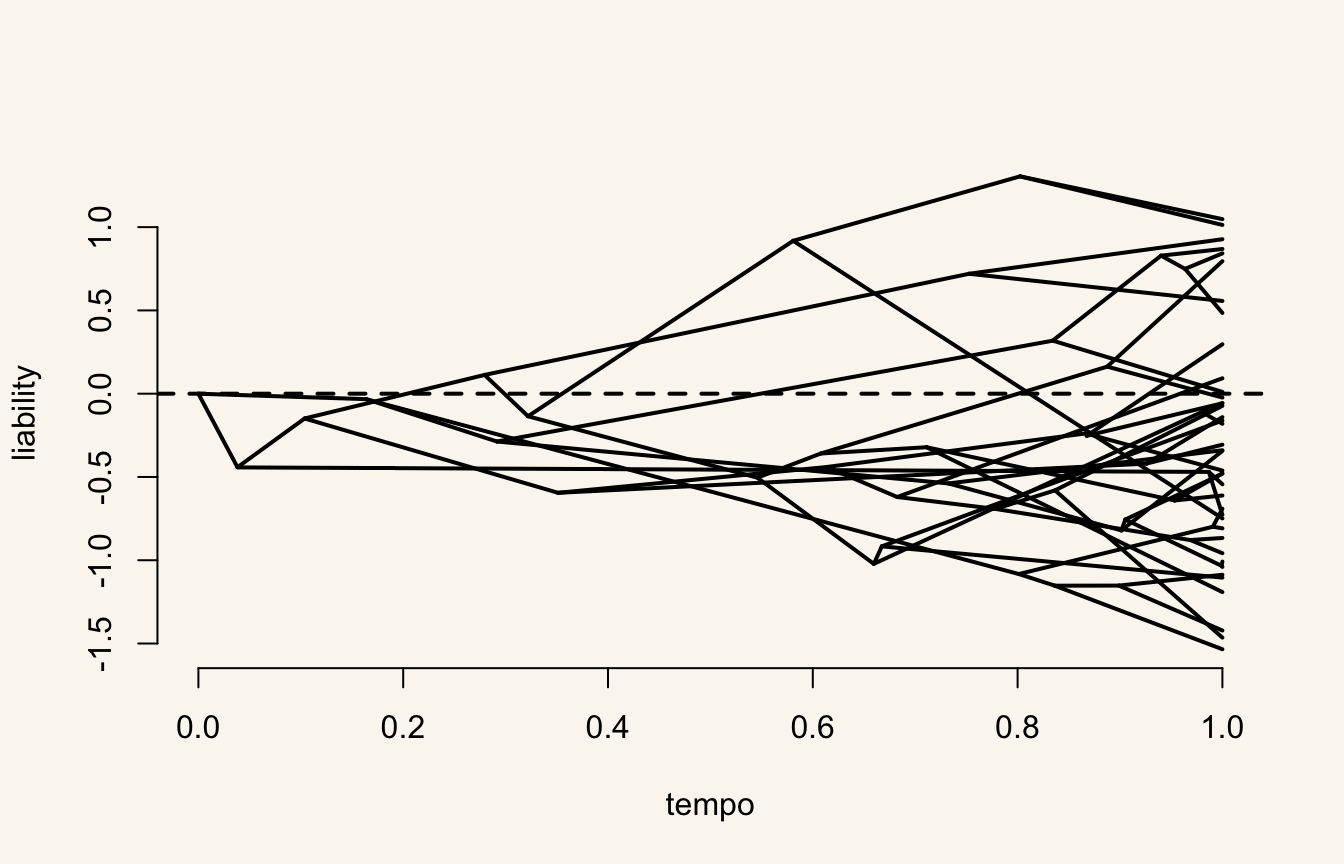
table(estado)estado
0 1
29 11 A correlação entre caracteres pelo limiar se estima com phytools::threshBayes() (MCMC, demorado); o código fica de referência:
threshBayes(arvore, cbind(x_discreto, y_continuo), types = c("discrete", "continuous"),
            ngen = 1e6)
Resumo
- Q guarda as taxas; P(t) = eQt dá as probabilidades num ramo (
matexpo()). - ER, SYM e ARD se comparam por AICc (
fitDiscrete(),fitMk()); taxas ocultas comcorHMM(). - O teste de Pagel (
fitPagel()) sofre de pseudorreplicação: compare comfitCorrelationTest(). - O modelo de limiar trata o estado discreto como um atributo contínuo escondido.
O Mk e o teste de Pagel da edição de 2020 estão nos roteiros das Aulas 2 e 5.