library(ape)
library(phytools)
library(geiger)Roteiro prático — Sinal filogenético
Aula 3 · Métodos Filogenéticos Comparativos
0. Pacotes e dados
Os cantos de 19 espécies de anuros da Serra da Bocaina (Garey et al. 2018). O arquivo usa ponto e vírgula como separador.
arv <- read.tree("filogenia_bocaina.txt")
canto <- read.csv("canto.csv", sep = ";", row.names = 1)
name.check(arv, canto)
[1] "OK"head(canto[, c("F_dom", "duracao_canto", "seas_repro")]) F_dom duracao_canto seas_repro
Bokermannohyla_ahenea 1240.313 1.2794000 1
Bokermannohyla_circumdata 1044.375 0.1282000 1
Aplastodiscus_perviridis 2054.665 0.1346727 1
Hypsiboas_bandeirantes 4857.893 0.1236667 2
Scinax_hayii 861.300 0.2608667 1
Scinax_duartei 3123.750 0.3027667 2Vamos usar o log da frequência dominante, como nos slides, num vetor com os nomes das espécies.
fdom <- setNames(log(canto$F_dom), rownames(canto))plotTree.barplot(arv, fdom, args.plotTree = list(fsize = .6),
args.barplot = list(xlab = "log da frequência dominante"))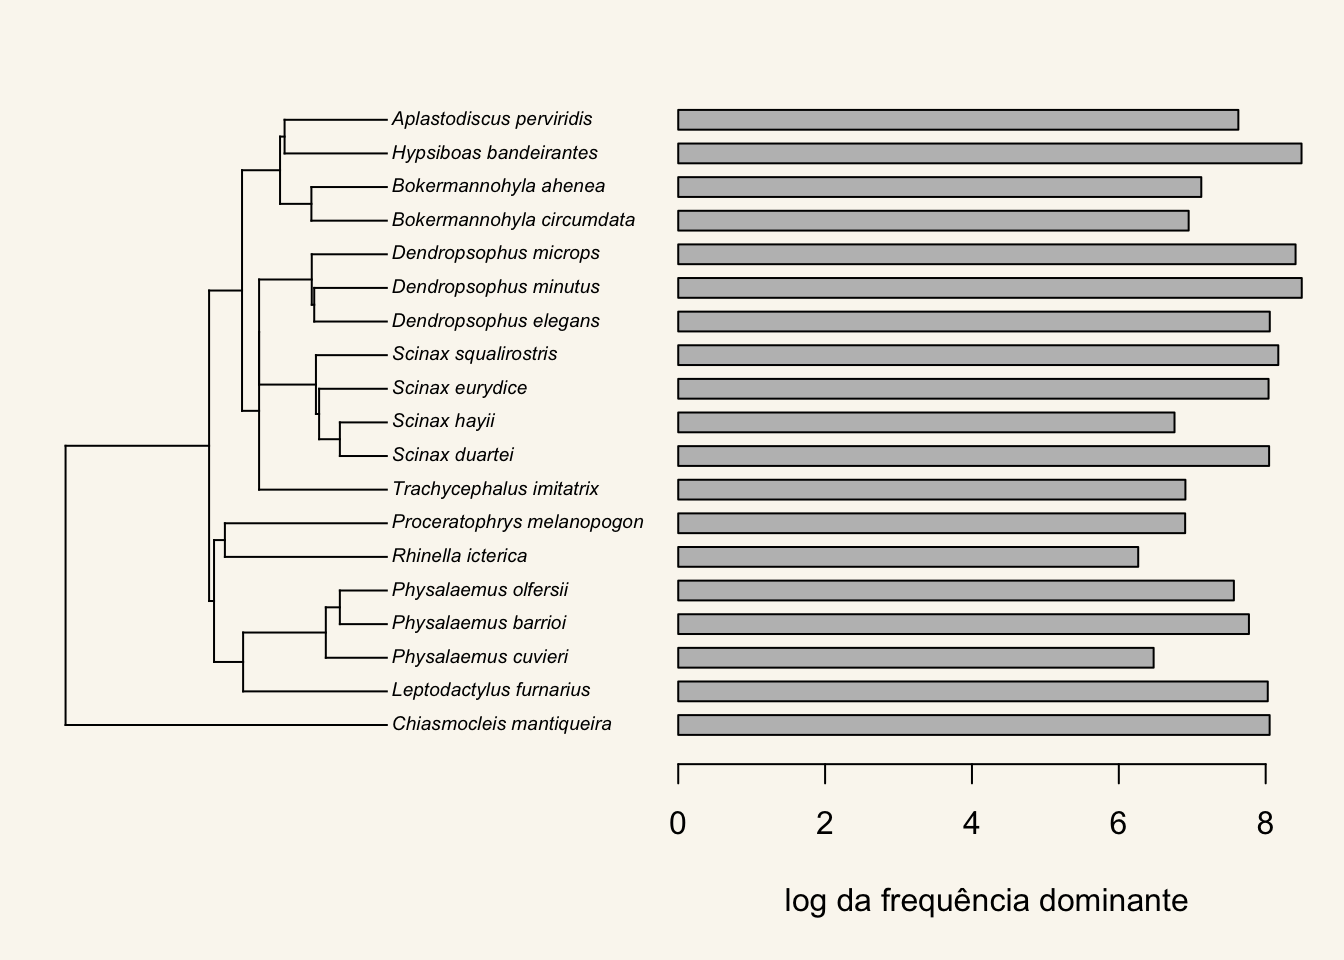
1. K de Blomberg
K compara a semelhança entre parentes com a esperada sob movimento browniano: K = 1 sob BM, K < 1 menos sinal que o BM, K > 1 mais. O teste permuta os valores entre as pontas da árvore.
set.seed(301)
k_fdom <- phylosig(arv, fdom, method = "K", test = TRUE, nsim = 999)
k_fdom
Phylogenetic signal K : 0.530582
P-value (based on 999 randomizations) : 0.375375 plot(k_fdom)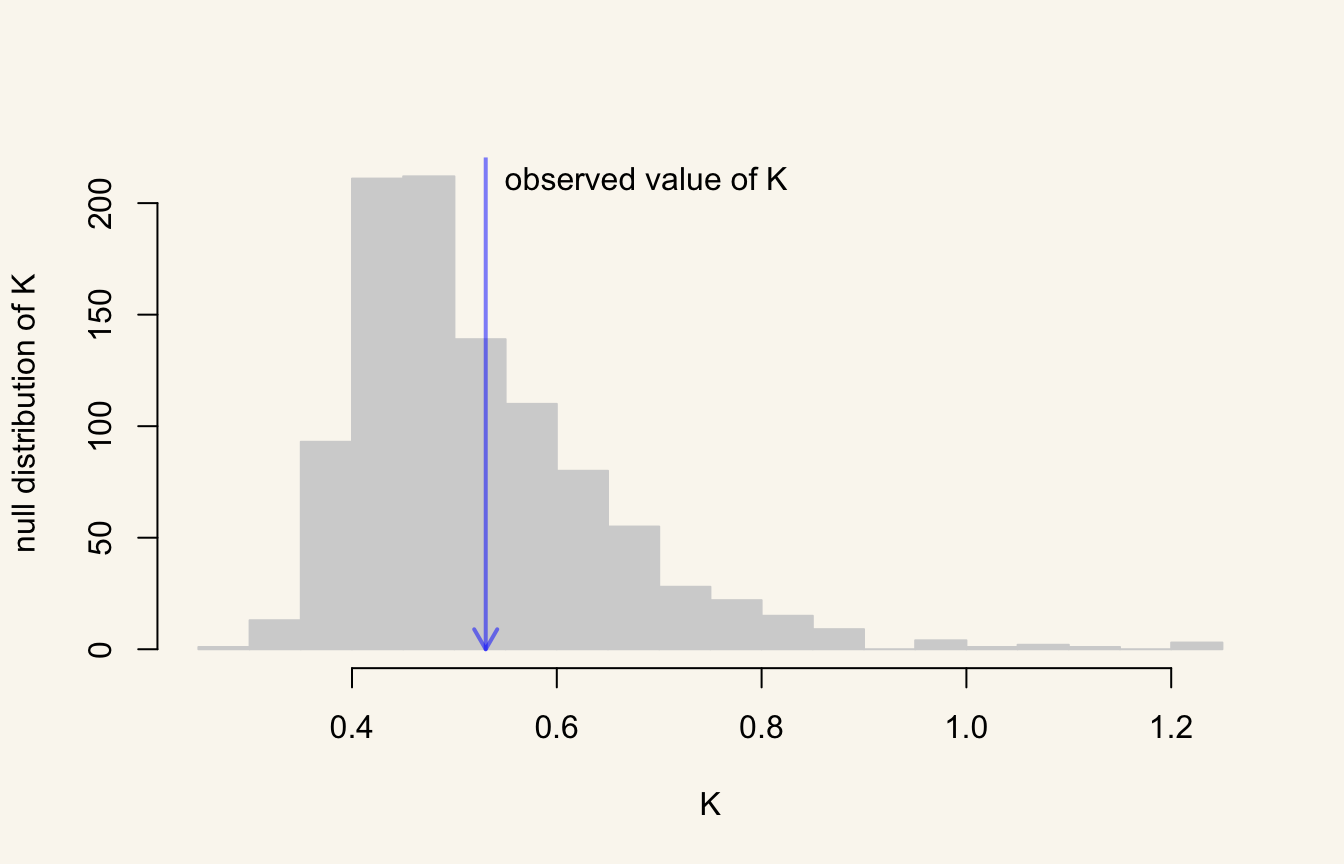
O histograma é a distribuição de K com os valores embaralhados entre as pontas; a linha é o K observado. Aqui, K = 0,53 e o K observado cai no meio da distribuição nula: nenhum sinal detectável na frequência dominante destes anuros.
2. λ de Pagel
λ multiplica as covariâncias da matriz C (Aula 2): λ = 0 é a árvore em estrela, λ = 1 é o BM. É estimado por máxima verossimilhança, e o teste compara com λ = 0.
l_fdom <- phylosig(arv, fdom, method = "lambda", test = TRUE)
l_fdom
Phylogenetic signal lambda : 7.33137e-05
logL(lambda) : -19.8131
LR(lambda=0) : -0.000586167
P-value (based on LR test) : 1 plot(l_fdom)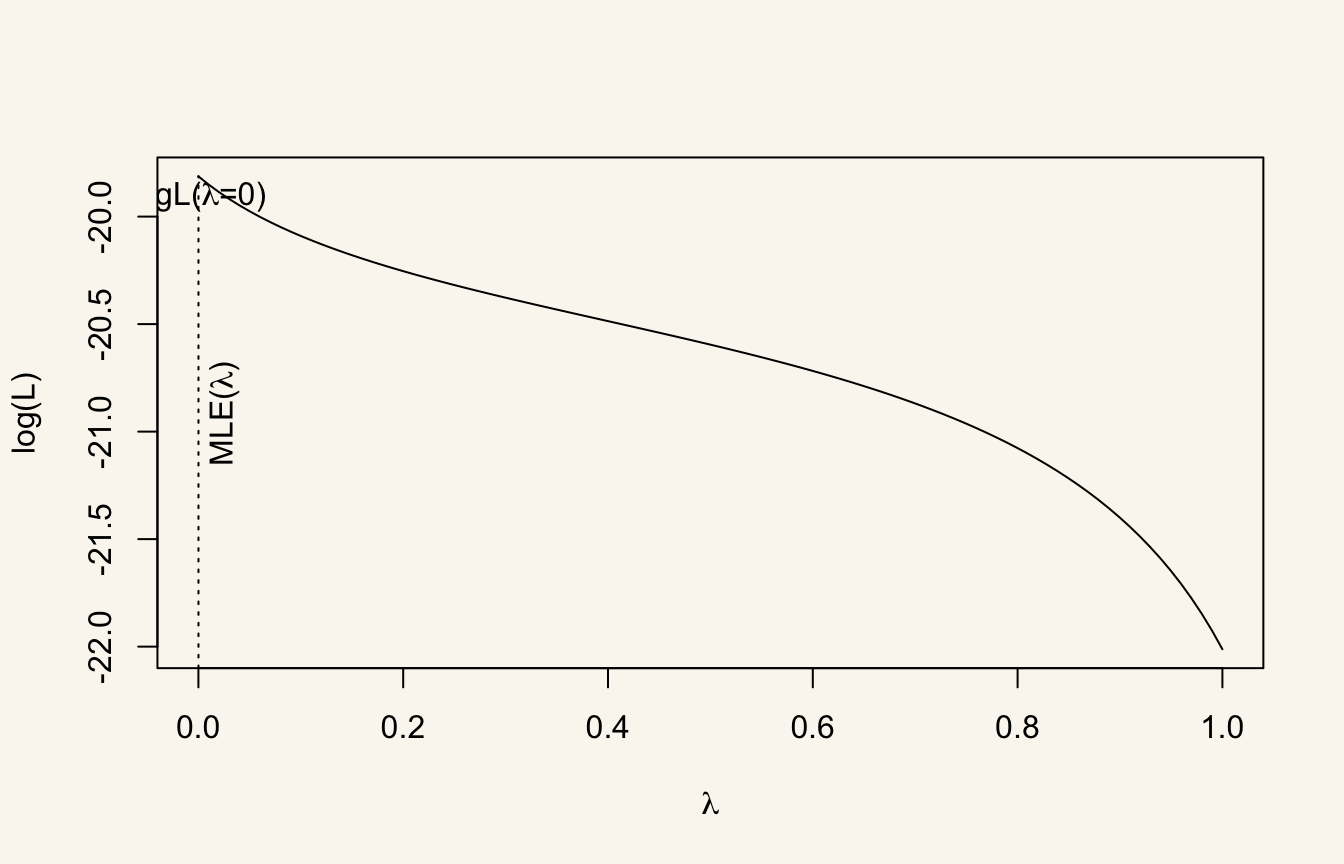
O perfil de verossimilhança mostra quão bem definido está λ: um perfil achatado quer dizer que os dados não distinguem bem os valores de λ, o que é comum com poucas espécies (aqui, 19). O λ estimado é praticamente zero, de acordo com o K.
3. Referências: um atributo browniano e um aleatório
Um K ou λ isolado diz pouco. Compare com dois atributos simulados na mesma árvore: um por BM e outro sem relação nenhuma com ela.
set.seed(302)
x_bm   <- fastBM(arv)
x_acaso <- setNames(rnorm(Ntip(arv)), arv$tip.label)
ref <- sapply(list(fdom = fdom, BM = x_bm, acaso = x_acaso), \(x)
  c(K = phylosig(arv, x, "K"), lambda = phylosig(arv, x, "lambda")$lambda))
round(ref, 2)
fdom BM acaso
K 0.53 0.9 0.42
lambda 0.00 1.0 0.00A frequência dominante se parece mais com o atributo aleatório do que com o browniano. Rode com outras sementes: com 19 espécies, até o atributo browniano varia bastante de uma simulação para outra.
4. Autocorrelação: I de Moran e C de Abouheif
O I de Moran mede se espécies próximas na árvore têm valores parecidos, dada uma matriz de pesos W (aqui, o inverso da distância patrística).
W <- 1 / cophenetic(arv)
diag(W) <- 0
Moran.I(fdom[rownames(W)], W)
$observed
[1] -0.04525311
$expected
[1] -0.05555556
$sd
[1] 0.02633947
$p.value
[1] 0.6956932O C de Abouheif usa uma proximidade calculada da topologia (adephylo):
library(adephylo)
library(phylobase)
p4 <- phylo4d(arv, data.frame(fdom = fdom[arv$tip.label]))
set.seed(303)
abouheif.moran(p4, method = "oriAbouheif", nrepet = 999)
class: krandtest lightkrandtest
Monte-Carlo tests
Call: as.krandtest(sim = matrix(res$result, ncol = nvar, byrow = TRUE),
obs = res$obs, alter = alter, names = test.names)
Number of tests: 1
Adjustment method for multiple comparisons: none
Permutation number: 999
Test Obs Std.Obs Alter Pvalue
1 fdom 0.1655046 1.178177 greater 0.1325. Mantel: distâncias fenotípicas × filogenéticas
O teste de Mantel correlaciona duas matrizes de distância: aqui, a diferença entre os cantos e a distância patrística.
D_filo <- cophenetic(arv)
D_fen  <- as.matrix(dist(fdom[rownames(D_filo)]))
set.seed(304)
mantel.test(D_fen, D_filo, nperm = 999)
$z.stat
[1] 25155.39
$p
[1] 0.997
$alternative
[1] "two.sided"O Mantel tem pouco poder para detectar sinal filogenético (Harmon & Glor 2010, citados nos slides): prefira K, λ ou Moran para essa pergunta.
6. PVR: componente filogenético e específico
A regressão por autovetores filogenéticos: autovetores da matriz de distâncias patrísticas (uma PCoA) entram como preditores do atributo.
pcoa <- cmdscale(D_filo, k = 3, eig = TRUE)
autovetores <- pcoa$points
colnames(autovetores) <- paste0("V", 1:3)
pvr <- lm(fdom[rownames(autovetores)] ~ autovetores)
summary(pvr)$r.squared
[1] 0.1617416O R² é a parte da variação do canto explicada pela filogenia (com 3 autovetores; a escolha de quantos é um ponto delicado do método). Os valores ajustados são o componente filogenético (P), e os resíduos, o componente específico (S):
comp <- cbind(P = fitted(pvr) - mean(fitted(pvr)), S = resid(pvr))
rownames(comp) <- rownames(autovetores)
plotTree.barplot(arv, comp[arv$tip.label, ], args.plotTree = list(fsize = .6),
                 args.barplot = list(beside = TRUE, legend.text = c("P", "S"),
                                     xlab = "log da frequência dominante, centrado"))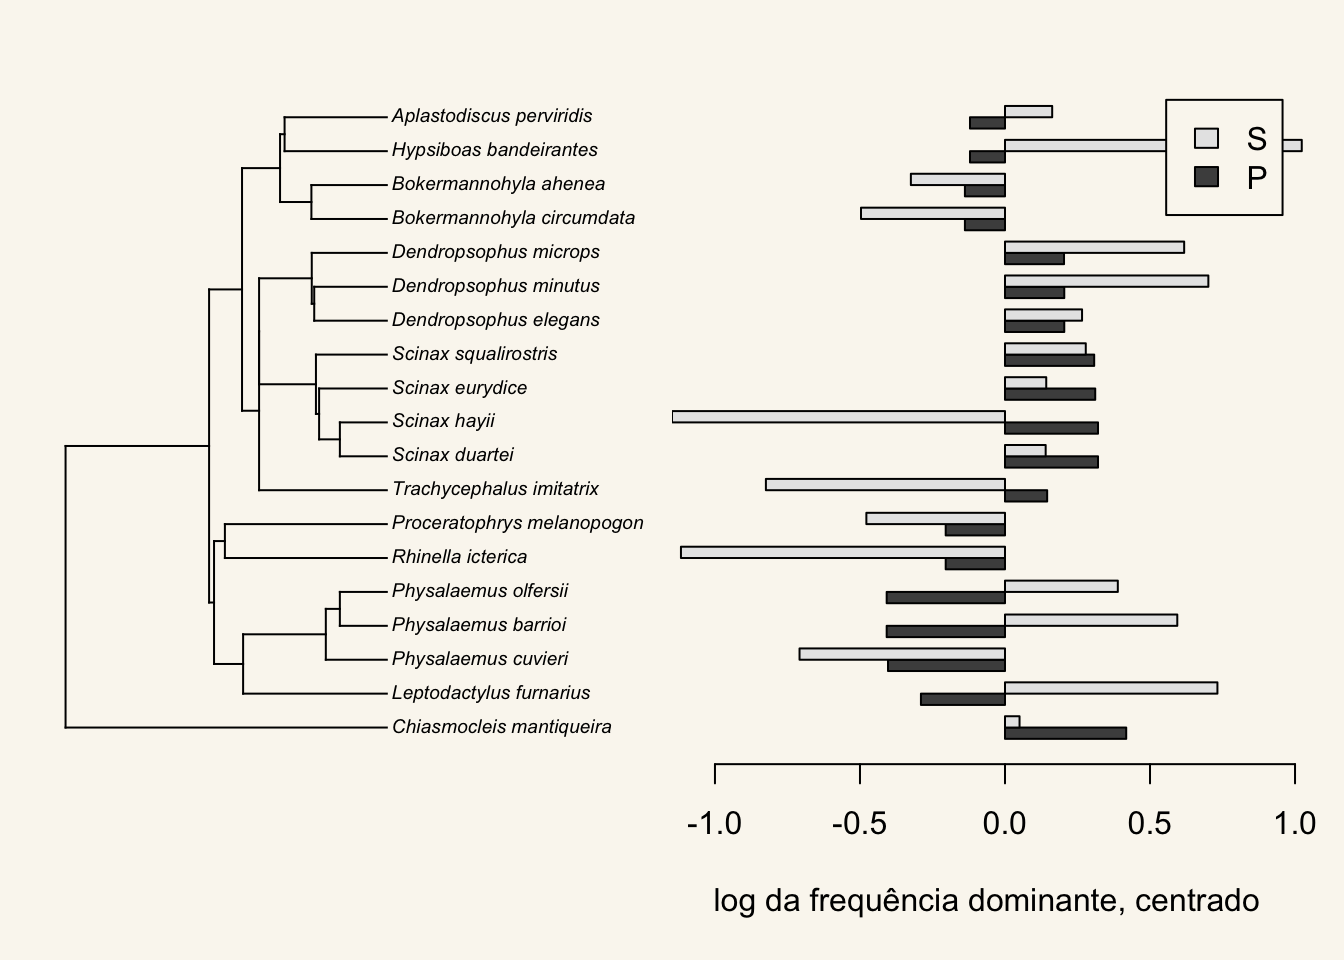
7. Atributos binários: o D de Fritz & Purvis
Para um atributo binário, o D compara a soma das mudanças de estado com o esperado sob BM com limiar (D = 0) e com o acaso (D = 1). Usamos a sazonalidade da reprodução (1 ou 2).
library(caper)
canto$sp <- rownames(canto)
canto$sazonal <- as.integer(canto$seas_repro == 2)
arv_d <- arv
arv_d$node.label <- NULL
cd <- comparative.data(arv_d, canto, names.col = "sp")
set.seed(305)
phylo.d(cd, binvar = sazonal, permut = 999)
Calculation of D statistic for the phylogenetic structure of a binary variable

  Data :  canto
  Binary variable :  sazonal
  Counts of states:  0 = 12
                     1 = 7
  Phylogeny :  arv_d
  Number of permutations :  999

Estimated D :  2.398649
Probability of E(D) resulting from no (random) phylogenetic structure :  0.974975
Probability of E(D) resulting from Brownian phylogenetic structure    :  0.003003003
D > 1 quer dizer que o atributo está mais disperso na árvore do que ao acaso: espécies próximas tendem a diferir na sazonalidade. Com 19 espécies e só 7 num dos estados, o teste tem pouco poder: leia o D junto com os dois valores-p (contra D = 1 e contra D = 0).
Resumo
- K e λ medem sinal de formas diferentes; compare-os com referências simuladas na mesma árvore.
- Sinal é um padrão: K ou λ alto não mostram restrição nem processo.
- Moran e Abouheif medem autocorrelação; o Mantel tem pouco poder para essa pergunta.
- O PVR separa um componente filogenético de um específico; o D faz o papel do K para atributos binários.
O roteiro da edição de 2020 tem o correlograma de Moran e mais exemplos; a decomposição da diversidade pelos nós está no roteiro da Pavoine.