IA na revisão de literatura
Como as ferramentas buscam, onde elas falham e como reportar
Instituto de Biociências, UFMS · Biodiversity Synthesis Lab
19 de outubro de 2026
Como este workshop funciona
Pergunta-guia: uma busca assistida por IA é um método — que se descreve, se justifica e se reproduz — ou um atalho?
| Bloco | Min | |
|---|---|---|
| 1 | A web que os robôs leem — e por que isso chega à sua revisão | 25 |
| 2 | A saída: bases legíveis por máquina | 20 |
| — | Intervalo / instalar o que falta | 10 |
| 3 | Mão na massa: a mesma pergunta em duas ferramentas + R | 40 |
| 4 | Demonstração: agente com MCP | 10 |
| 5 | Fechamento: modelos abertos, acesso e como declarar | 15 |
Slides, código e todas as referências: https://provetelab.org/ia-revisao-literatura/
O que você precisa ter aberto agora
Contas gratuitas (criar antes de começar):
- Consensus — https://consensus.app
- Undermind — https://undermind.ai
R com os pacotes:
Traga uma coisa sua: uma revisão (sua ou de alguém do seu grupo) cuja lista de referências você conhece bem.
É com ela que vamos medir o que as ferramentas acham — e o que elas perdem.
Se der problema de instalação, não pare o workshop por isso: os blocos 1, 2, 4 e 5 não dependem de R.
0 · De onde viemos
A palestra anterior parou em “declare”
Em IA na redação científica fechamos com cinco regras. Uma delas era:
Verifique cada referência até o DOI, e confira se ela diz o que você afirma.
Isso resolve o reporte. Não resolve a pergunta anterior, que é a deste workshop:
Se a busca em si passou a ser feita por uma máquina, a busca virou parte do método — e método se descreve, se justifica e se reproduz. Estamos preparados para descrever o que essas ferramentas fazem?
Slides da palestra anterior: https://provetelab.org/ia-escrita-cientifica/
Um editor faz a pergunta em voz alta
Editorial de Reviews in Aquaculture, julho de 2026. O título já é a tese inteira:
Can AI Write Your Next Review? Yes. Does That Make Real Review Articles Redundant? No
E o autor não desvia da versão incômoda da pergunta — citando pelo nome uma das ferramentas que vamos usar hoje:
“Tools such as Scholar Gateway, Wiley’s own AI search platform, can already scan the full corpus of published Wiley articles and return a fast, credible, well-referenced summary of a topic. These tools are good now, and they are improving quickly. If a machine can produce a competent synthesis of the literature in seconds, why do we still need review articles written by people?”
A resposta dele separa duas coisas que costumamos confundir: “Synthesising literature is not the same as understanding it from the inside.”
Declaração de conflito de interesse: sou editor na Wiley, que publica esse periódico e mantém o Scholar Gateway citado acima.
Turchini GM (2026). Reviews in Aquaculture 18:e70196. doi:10.1111/raq.70196 — acesso aberto.
Por que esse editorial abre o workshop e não o encerra
Ele responde “por que ainda precisamos de revisões escritas por gente?” assim: quem fez a pesquisa primária sabe onde estão as fraquezas metodológicas do campo, sabe o que os dados não dizem, e sabe onde a incerteza é real. Nada disso está no texto publicado — portanto nada disso é recuperável por busca.
“A well-referenced summary of the literature, however fluently written, is not a review article just because it is structured like one.”
Mas guardem uma frase dele para o bloco 3. Quando o editorial afirma que essas ferramentas “are good now”, isso é juízo de editor, não medição — e vai bater de frente com a evidência quantitativa que veremos. Ter as duas coisas na mesa é o ponto: a percepção de quem edita e o número de quem mediu não estão no mesmo lugar.
E há uma diferença de escopo: o editorial trata de escrever revisões, que era a palestra anterior. Hoje o assunto é a etapa antes dela — achar o que vai ser revisado.
Três teses que este workshop defende
A web deixou de ser legível por programas — e isso tem consequências técnicas concretas para qualquer ferramenta que prometa “ler a literatura”.
Alucinação de referência e bloqueio de acesso são dois problemas diferentes, com causas diferentes e soluções diferentes. Confundi-los leva a diagnósticos errados.
Busca assistida por IA tem alta precisão e baixa sensibilidade. Isso não a torna inútil — torna-a adequada para um conjunto específico de tarefas, e inadequada para outro. Saber qual é qual é o conteúdo técnico do workshop.
Se você sair daqui com só uma coisa, que seja a terceira.
1 · A web que os robôs leem
Demonstração ao vivo · a alucinação acontecendo 8 min
Antes de qualquer slide sobre o problema, vamos produzir o problema aqui, agora, juntos.
Protocolo — façam junto comigo
- Alguém da sala dá o tema. Quanto mais específico e mais nosso, melhor: um gênero de anuro, uma região, um processo.
- Eu peço a um LLM sem busca (chat comum, sem “deep research”, sem navegação): “Liste 5 artigos revisados por pares sobre
, com autores, ano, periódico e DOI.” - Projeto a resposta. Todo mundo lê. Parece perfeita.
- Rodo o verificador no R, ao vivo, contra a API do CrossRef.
- Contamos no quadro: de 5, quantos existem?
A aposta que eu faço agora, antes de rodar: pelo menos um DOI vai apontar para um artigo que existe mas não é aquele. Esse é o caso mais perigoso — sobrevive a uma conferência apressada.
O verificador (rodando ao vivo)
library(httr2); library(purrr); library(tibble)

checa_doi <- function(doi) {
  r <- request("https://api.crossref.org/works") |>
    req_url_path_append(doi) |>
    req_user_agent("workshop-ppgba (mailto:seu.email@ufms.br)") |>
    req_error(is_error = \(resp) FALSE) |>
    req_perform()

  if (resp_status(r) != 200)
    return(tibble(doi = doi, existe = FALSE, titulo = NA_character_))

  m <- resp_body_json(r)$message
  tibble(doi = doi, existe = TRUE, titulo = m$title[[1]])
}

dois <- c("10.1111/2041-210X.13268",   # existe
          "10.1038/s41586-026-99999-x") # não existe

map(dois, checa_doi) |> list_rbind()
existe = TRUE não encerra a checagem. Falta a pergunta que só você responde: o título que voltou é o que a citação dizia? Um DOI válido colado numa referência errada é o modo de falha que passa despercebido.
Por que aquilo aconteceu
A explicação que você vai ouvir — e que eu já dei, errada, para o meu próprio orientando — é “o modelo não tinha acesso à internet”.
Está errada. Falta de acesso não é a causa da invenção de referências. São dois mecanismos independentes, e tratar um como causa do outro leva à conclusão falsa de que “se o site abrisse, o modelo não inventaria”. Ele inventaria do mesmo jeito.
Mecanismo A — geração paramétrica
O modelo gera o próximo token a partir de uma memória comprimida dos dados de treino. Ele produz a forma de uma citação.
Um DOI é uma string arbitrária de alta entropia: não há regularidade linguística que o modelo possa aprender. É, literalmente, o pior tipo de objeto para um modelo generativo produzir de memória.
Mecanismo B — ancoragem ruim
RAG — retrieval-augmented generation, geração aumentada por recuperação. O modelo primeiro busca documentos, depois gera a resposta a partir do que recuperou. É o que Consensus, Undermind e o ChatGPT com busca fazem.
Se a recuperação traz pouco, ou traz a casca vazia que vamos ver adiante, o modelo preenche a lacuna com plausibilidade.
Aqui o bloqueio agrava — mas o erro continua sendo de geração, não de acesso.
Os dois mecanismos, lado a lado
Abrir o site bloqueado resolve B, e não toca em A.
Diagrama original · CC BY 4.0.
A escala, medida na literatura publicada
Zhao et al. (2026) verificaram 111 milhões de referências em 2,5 milhões de artigos e preprints do arXiv, bioRxiv, SSRN e PubMed Central:
146.932 referências inexistentes em trabalhos de 2025 — e os autores chamam de estimativa conservadora
- Aumento abrupto a partir da adoção ampla de LLMs.
- Concentradas em campos de adoção rápida de IA e em textos com marcadores linguísticos de escrita assistida.
- O SSRN — majoritariamente ciências sociais — lidera a prevalência.
- “Preprint moderation and journal publication processes capture only a fraction of these errors.”
É preprint, não passou por revisão por pares. Trate como a melhor estimativa disponível, não como número fechado — e diga isso à plateia, porque é exatamente a postura que o workshop defende.
Zhao Z, Wang Y, Stuart T, De Vaan M, Ginsparg P, Yin Y (2026). LLM hallucinations in the wild: Large-scale evidence from non-existent citations. arXiv:2605.07723 · Cobertura: Stokel-Walker C, Nature (14/05/2026) https://www.nature.com/articles/d41586-026-01545-1 e Naddaf M, Quill E, Nature (01/04/2026) https://www.nature.com/articles/d41586-026-00969-z
Quem é mais atingido
No mesmo levantamento, as citações inexistentes não se distribuem ao acaso:
- aparecem mais em trabalhos de equipes pequenas e de pesquisadores em início de carreira;
- e, quando inventadas, atribuem crédito desproporcionalmente a pesquisadores já proeminentes e a homens.
Ou seja: quem tem menos estrutura de verificação erra mais, e o erro reforça a hierarquia de prestígio que já existe. A alucinação não é ruído aleatório — ela tem direção.
Some isso ao que vamos ver adiante (Kim et al. 2025): a taxa de invenção é maior para a literatura de países de baixa renda. Duas assimetrias, no mesmo sentido.
Zhao et al. (2026), arXiv:2605.07723 — preprint.
Quanto se inventa, em condição controlada
O levantamento acima mede o que sobreviveu até a publicação. Este mede o processo na origem: Seifi & Seyfi (2026) submeteram 10 tópicos de neurointensivismo a três modelos sem acesso à web (zero-shot, recuperação desligada), pedindo 10 referências por tópico — 300 referências, conferidas às cegas por dois especialistas contra PubMed, DOI, Google Scholar e CrossRef:
- 55,0% (165/300) continham alguma imprecisão de citação;
- 28,3% (85/300) eram completamente fabricadas;
- por modelo: DeepSeek-V3 23% (fabricação 8%), GPT-5.3 69% (27%), Grok-4 73% (50%).
- Concordância entre avaliadores excelente: κ = 0,91 (IC 95%: 0,86–0,96).
Metade das referências do modelo pior não existia. E elas “appear complete and credible” — é exatamente esse o problema.
Segundo o PubMed: Seifi A, Seyfi A (2026). Hallucination Rate of Peer-Reviewed Citations Generated by Large Language Models in Neurocritical Care. Crit Care Explor 8(9):e1474. doi:10.1097/CCE.0000000000001474
Uma lição de medição, de graça
Um segundo estudo, no mesmo ano, com desenho parecido (1.800 referências de anatomia):
- ChatGPT 5.2: 23,2% de alucinação — a menor taxa
- Gemini 3 Pro: 45,8% · DeepSeek V3.2: 47,5% — a maior
Os dois estudos invertem o ranking dos modelos. No primeiro, DeepSeek é o melhor e GPT o pior; no segundo, o contrário.
O que os dois concordam: as taxas são altas em termos absolutos, e verificação humana é obrigatória. O que não se sustenta: qualquer frase do tipo “use o modelo X, que inventa menos”. Versões, prompts, domínios e critérios de julgamento diferem — estamos medindo um alvo móvel com réguas incomparáveis.
Segundo o PubMed: Ülkir M, Paslı B (2026). Reference Hallucination, Citation Reliability, and Readability of Large Language Models in Anatomy-Related Question Answering. Clin Anat. doi:10.1002/ca.70187
E a alucinação não é uniforme no globo
Kim, Kipchumba & Min (2025) validaram 3.451 citações geradas por quatro modelos contra a API do CrossRef, estratificando por país de origem da publicação:
As taxas de alucinação passaram de 80% para publicações de países de baixa renda — e a fabricação cresceu forte para publicações dos anos 2020 em todas as regiões.
Na ordem de importância dos fatores: modelo > nível de renda do país > período de publicação.
Para nós isso é concreto: a literatura brasileira, latino-americana e africana é justamente a que o modelo conhece pior — e portanto a que ele mais inventa. Guarde isto para o bloco 5.
Kim E, Kipchumba F, Min S (2025). Geographic Variation in LLM DOI Fabrication: Cross-Country Analysis of Citation Accuracy Across Four Large Language Models. Publications 13(4):49. doi:10.3390/publications13040049
Em junho de 2026, os robôs passaram as pessoas
Até aqui, o mecanismo A. O resto deste bloco é sobre o B — por que a ferramenta que tem busca ainda assim recupera pouco. E isso começa longe da ciência: começa em como a web mudou.
57,5% / 42,5% divisão das requisições HTTP entre bots e humanos, segundo os dados da Cloudflare
“Welp, that happened faster than I predicted. Thought it would be end of 2027, then early 2027, but agentic traffic growing so fast that bots have now passed human traffic online for the first time in the Internet’s history.”
— Matthew Prince, CEO da Cloudflare, 3 de junho de 2026
Cuidado com este número. É a medição de uma empresa, sobre a fração da web que passa por ela, com uma classificação de tráfego recente — o próprio Prince diz que o dado “is a bit messy”. Use como ordem de grandeza, não como estatística.
Tom’s Hardware (04/06/2026), a partir de postagem de M. Prince: https://www.tomshardware.com/tech-industry/artificial-intelligence/bots-have-now-passed-human-traffic-online-cloudflare-boss-laments-says-agentic-traffic-wasnt-expected-to-eclipse-real-people-until-next-year
O Brasil não é a média mundial
A Cloudflare publica o mesmo indicador por país, em tempo real:
Ao vivo agora: https://radar.cloudflare.com/bots/br
O que olhar na tela: a proporção bot/humano do Brasil, a série temporal, e — se der tempo — comparar com /bots/us.
Os números mudam de semana para semana — por isso não estão fixados em nenhum slide.
Cloudflare Radar, painel público por país.
“Teoria da internet morta”: o que ela acerta e o que ela erra
O que a metáfora acerta
- Uma fração crescente do conteúdo online é gerada por máquina.
- Uma fração crescente do tráfego é de máquina.
- Sinais que usávamos para avaliar relevância (visualizações, engajamento, links) ficaram menos informativos.
O que ela erra
- Na formulação original é uma teoria da conspiração — supõe intenção coordenada de ocultar pessoas reais.
- Não é uma hipótese testável do jeito que é enunciada.
- Nada disso é necessário para o argumento deste workshop.
Use como figura de linguagem, declarando que é figura de linguagem. O fenômeno mensurável — tráfego e conteúdo automatizados — é suficiente e não precisa de conspiração.
O verbete abaixo reúne a origem, as formulações e a recepção da ideia. É fonte terciária: serve para documentar o que a teoria afirma e de onde ela veio — não para sustentar afirmação empírica. Os números deste bloco vêm das fontes primárias dos outros slides.
Dead Internet theory: https://en.wikipedia.org/wiki/Dead_Internet_theory
Por que uma página deixou de ser um documento
Correção de um erro comum: não é que “o HTML5 foi substituído por JSON e CSS”. HTML continua sendo o formato da página. O que mudou foi quem monta a página.
- Antes (web de documentos): o servidor devolvia HTML com o conteúdo dentro.
curlnuma URL trazia o texto. - Agora (single-page applications): o servidor devolve um HTML praticamente vazio + JavaScript. O JavaScript chama uma API que devolve JSON, e monta o conteúdo no navegador.
Consequência: um programa que apenas baixa a URL recebe a casca, não o conteúdo. Para ver o que você vê, ele precisaria executar um navegador inteiro.
Isso se chama client-side rendering. Não é conspiração contra robôs: é escolha de arquitetura feita por outras razões — interatividade, custo de servidor. O efeito colateral é que a web ficou mais cara de ler por máquina.
Demonstração 1 · a casca vazia
Ao preparar estes slides, tentei buscar programaticamente o número de bots do Brasil na página da Cloudflare Radar. O que voltou:
“Based on the webpage content provided, no specific numerical data is shown for Brazil’s bot vs. human traffic share. […] The page appears to be a dashboard interface where visualizations would typically be displayed, but those data points are not present.”
A página existe, abriu, não foi bloqueada — e mesmo assim não tinha número nenhum. Os números chegam depois, por JSON, quando um navegador executa o JavaScript.
Este é o modo de falha mais comum e o menos percebido: a ferramenta não erra — ela simplesmente não vê.
Por que o robô é barrado: quatro motivos distintos
| Motivo | Quem impõe | Mecanismo |
|---|---|---|
| Carga de servidor | qualquer site | limite de taxa, captcha, rate limiting |
Termos de uso / robots.txt |
o site | convenção; obedecida por crawlers “bem-comportados” |
| Segurança | CDN / WAF | detecção de bot, desafio de JavaScript, captcha |
| Licenciamento de conteúdo | editora / CDN | bloqueio por padrão + cobrança por acesso |
O quarto motivo é o novo. Desde 1º de julho de 2025 a Cloudflare bloqueia crawlers de IA por padrão em sites novos e lançou o pay-per-crawl: o acesso deixou de ser livre e passou a ser negociado.
Cloudflare, Content Independence Day: no AI crawl without compensation! (01/07/2025): https://blog.cloudflare.com/content-independence-day-no-ai-crawl-without-compensation/
Demonstração 2 · o 403
Tentativa de ler programaticamente um artigo de acesso aberto na Wiley Online Library:
Error: There was an error while fetching: The page returned a 403 client errorE na PubMed Central, a mesma tentativa devolveu uma página de reCAPTCHA do Google — não o artigo.
O artigo é aberto. A licença permite. O acesso automatizado, não. Acesso aberto e acesso legível por máquina são coisas diferentes — e a segunda vem sendo restringida.
Ambos os casos ocorreram durante a preparação destes slides, em setembro de 2026. O mesmo artigo foi obtido depois por uma API — que é exatamente a saída do bloco 2.
O que muda na revisão de literatura
Um LLM sem busca não é uma ferramenta de revisão de literatura. É um gerador de texto com formato de bibliografia.
Isso não é um problema a ser consertado com prompt melhor. É uma propriedade do mecanismo.
A saída é mudar a arquitetura: em vez de pedir referências ao modelo, dar referências ao modelo — recuperadas de uma base com identificadores persistentes, por um canal legível por máquina.
É disso que trata o bloco 2.
2 · Bases legíveis por máquina
O que faz uma base ser “legível por máquina”
Não é ter um site bonito. São três coisas:
- Uma API pública e documentada — um endereço que devolve dados estruturados (JSON), não uma página para humanos.
- Identificadores persistentes — DOI, ORCID, ISSN, ROR. É o que permite dizer “este objeto é aquele objeto” sem adivinhação.
- Uma licença que permite o uso — reuso, redistribuição, mineração.
Quando as três existem, o problema do bloco 1 desaparece: não há casca vazia para renderizar, não há captcha, e o DOI vem da base em vez de ser gerado pelo modelo.
OpenAlex
- Mantido pela OurResearch, organização sem fins lucrativos (mesma gente do Unpaywall).
- Dados em CC0 — domínio público. Pode baixar o dump inteiro.
- API pública, sem chave obrigatória (basta declarar um e-mail de contato para entrar no pool rápido).
- Sucessor do Microsoft Academic Graph, descontinuado em 2021.
O que isso significa na prática
É a única base grande de metadados bibliográficos que você pode replicar inteira na sua máquina. Uma busca feita nela é auditável por terceiros sem assinatura.
Para reprodutibilidade, essa é a propriedade que importa.
https://openalex.org · documentação da API: https://docs.openalex.org
Semantic Scholar
- Mantido pelo Allen Institute for AI (Ai2), instituto de pesquisa sem fins lucrativos em Seattle.
- Mais de 200 milhões de registros; API pública com chave gratuita.
- Diferencial: além de metadados, trabalha contextos de citação e embeddings — é o que permite busca semântica em vez de só booleana.
Por que isso importa para o bloco 3: boa parte das ferramentas comerciais que vamos testar roda em cima do Semantic Scholar. Elas não têm um índice próprio da literatura — têm uma camada de LLM sobre o índice do Ai2.
Quanto cada base cobre, em escala
Quatro em cada cinco registros do OpenAlex naquele período não estão nas outras duas bases. Buscar só na WoS ou na Scopus é trabalhar numa fatia — e é essa fatia que define o que existe, para quem busca por ali. Messeri & Crockett chamam isso de ilusão de amplitude exploratória: você acredita varrer o campo, quando varre o que a sua base indexa.
O que é dado e o que é desenho: as interseções par-a-par não são reportadas no artigo, então a geometria fora do núcleo comum é esquemática. Os totais de 2015–2022 foram derivados dos percentuais publicados.
Culbert JH, Hobert A, Jahn N, Haupka N, Schmidt M, Donner P, Mayr P (2025). Reference coverage analysis of OpenAlex compared to Web of Science and Scopus. Scientometrics. doi:10.1007/s11192-025-05293-3 · números do preprint arXiv:2401.16359 · Messeri & Crockett (2024), Nature 627:49–58
E a qualidade dos metadados
No mesmo corpus compartilhado de 16,8 milhões de publicações:
- Números médios de referências e taxas de cobertura interna comparáveis aos das duas bases proprietárias.
- ORCID: 92% no OpenAlex vs. 16% na WoS e 32% na Scopus.
- Resumos: 87% no OpenAlex vs. 92% nas outras duas.
Os autores não fazem propaganda: recomendam “caution when utilising OpenAlex for scientometric studies due to the volatility and data quality issues”. Cobertura comparável não é qualidade idêntica — o OpenAlex muda entre versões.
Culbert JH, Hobert A, Jahn N, Haupka N, Schmidt M, Donner P, Mayr P (2025). Reference coverage analysis of OpenAlex compared to Web of Science and Scopus. Scientometrics. doi:10.1007/s11192-025-05293-3
Cada ferramenta herda o viés do seu corpus
| Ferramenta | Sobre qual base busca | Quem controla |
|---|---|---|
| Consensus | Semantic Scholar + OpenAlex + crawl próprio (>200 M) | empresa privada |
| Scholar Gateway | só o portfólio da Wiley: >8 M artigos de >2.000 periódicos, em texto completo | Wiley |
| Undermind | busca agêntica iterativa; corpus não declarado na página | empresa privada |
| Elicit | Semantic Scholar (~126 M na avaliação de 2025) | empresa privada |
| LeapSpace | ecossistema Elsevier (Scopus/ScienceDirect) | Elsevier |
| Scite | contextos de citação sobre corpus próprio | empresa privada |
| NotebookLM | nada — só o que você subir |
Se todo mundo busca no mesmo índice, a “segunda opinião” é ilusória. Rodar Consensus e Elicit e obter listas parecidas não confirma nada: as duas estão perguntando à mesma base. Concordância entre ferramentas ≠ evidência.
O Scholar Gateway é o contraexemplo útil: corpus menor e de uma editora só, mas em texto completo. Acha coisa que as outras não acham — e ignora tudo que não é Wiley. Os dois fatos vêm da mesma escolha de corpus.
“Mas e o Google Scholar?”
É o que praticamente todo mundo nesta sala usa, e ele não apareceu em nenhuma lista até agora. Vale explicar por que ele é diferente dos outros — e quando ele continua sendo a melhor escolha.
Onde ele ganha de todos
- Rastreio de citações para frente — o “Cited by”. Gusenbauer (2024) avaliou os índices de citação de 59 bases e reafirmou o Google Scholar com as maiores contagens de citações recebidas.
- Cobertura larga e heterodoxa: teses, repositórios institucionais, literatura cinzenta, não-anglófona. Pega o que OpenAlex e Semantic Scholar indexam mal — que é justamente a nossa literatura.
Onde ele perde de todos
- Sem API pública, sem exportação em lote, cobertura não documentada, ranqueamento não divulgado.
- Resultados mudam por usuário, data e local.
- Não faz booleana séria: sem controle de vocabulário, sem truncagem decente, teto de resultados.
Gusenbauer & Haddaway (2020) testaram 28 sistemas de busca em precisão, revocação e reprodutibilidade e são diretos: “our findings demonstrate why Google Scholar is inappropriate as principal search system.”
A régua do workshop aplicada ao Google Scholar
Lembre da distinção do bloco anterior — busca é objeto ou é evento?
| Google Scholar | OpenAlex via API | |
|---|---|---|
| A consulta pode ir para o Methods? | não há string estável para colar | sim: o script é a consulta |
| Outra pessoa reexecuta em 2031? | não há garantia nenhuma | sim, com a versão da base |
| Dá para auditar o que ficou de fora? | cobertura não é publicada | o dump inteiro é baixável |
| Exporta 3.000 registros? | não | sim |
Conclusão prática, e ela não é “pare de usar”: o Google Scholar é excelente como ferramenta de descoberta e de rastreio de citações, e inadequado como busca principal de uma revisão sistemática. Use-o no passo das sementes e no passo das citações — e faça a busca principal onde ela possa ser escrita.
Gusenbauer M, Haddaway NR (2020). Which academic search systems are suitable for systematic reviews or meta-analyses? Evaluating retrieval qualities of Google Scholar, PubMed, and 26 other resources. Research Synthesis Methods 11(2):181–217. doi:10.1002/jrsm.1378 · Gusenbauer M (2024). Beyond Google Scholar, Scopus, and Web of Science: an evaluation of the backward and forward citation coverage of 59 databases’ citation indices. Research Synthesis Methods 15(5):802–817. doi:10.1002/jrsm.1729 · Comparador de bases: https://www.searchsmart.org
O risco de usar só isso
Nenhuma dessas bases indexa bem: literatura cinzenta, teses brasileiras, periódicos nacionais de baixa visibilidade, publicações em português, livros e capítulos de taxonomia.
Em ecologia e evolução isso não é um detalhe: boa parte do conhecimento de história natural de espécies neotropicais está exatamente aí.
A estratégia é mista, e a divisão de trabalho é clara:
| Tarefa | Quem faz melhor |
|---|---|
| Achar o que é semanticamente parecido, rápido | máquina |
| Saber que existe uma tese de 1998 de Manaus sobre isso | humano |
| Aplicar critério de inclusão a 4.000 títulos | máquina (com supervisão) |
| Decidir quais são os critérios de inclusão | humano |
| Julgar se um resultado é plausível dado o sistema de estudo | humano |
API ou MCP? A diferença em uma frase
API
Você escreve o código que faz a pergunta, recebe JSON e trata o resultado.
- Controle total sobre a consulta
- Reproduzível: o script é o método
- Exige programar
MCP (Model Context Protocol)
Um padrão aberto que expõe uma ferramenta para o modelo chamar sozinho, em linguagem natural.
- Sem código
- O modelo decide a consulta — e isso não fica registrado por padrão
- Menos reproduzível, exatamente por isso
Mesma base, dois níveis de controle. Para explorar: MCP. Para um método que vai para o Methods: API, com o script versionado.
openalexR: busca reprodutível em R
library(openalexR)
library(tidyverse)

options(openalexR.mailto = "seu.email@ufms.br")  # entra no pool rápido

girinos <- oa_fetch(
  entity    = "works",
  title_and_abstract.search = "tadpole AND (functional trait OR morphology)",
  from_publication_date = "2015-01-01",
  concepts.id = "C18903297",          # Ecology
  verbose = TRUE
)

girinos |>
  as_tibble() |>
  select(id, doi, display_name, publication_year, cited_by_count) |>
  arrange(desc(cited_by_count))
Este bloco é a seção de métodos. Ele diz a base, a consulta, a data, o filtro e a versão do pacote — e qualquer pessoa pode rodá-lo de novo.
Aria M, Le T, Cuccurullo C, Belfiore A, Choe J (2024). openalexR: An R-Tool for Collecting Bibliometric Data from OpenAlex. The R Journal 15(4):167–180. https://journal.r-project.org/articles/RJ-2023-089/ · rOpenSci: https://docs.ropensci.org/openalexR/
litsearchr: a busca booleana construída a partir dos dados
Pacote de R publicado em Methods in Ecology and Evolution — feito por e para gente da nossa área.
A ideia: em vez de chutar os termos de busca, você parte de um conjunto-semente, extrai as palavras-chave, monta uma rede de coocorrência e usa a estrutura da rede para decidir quais termos entram na busca.
É “automatizado” no sentido que interessa: o critério é explícito, quantitativo e reexecutável — o oposto de “o agente decidiu”.
Grames EM, Stillman AN, Tingley MW, Elphick CS (2019). An automated approach to identifying search terms for systematic reviews using keyword co-occurrence networks. Methods Ecol Evol 10:1645–1654. doi:10.1111/2041-210X.13268 · https://elizagrames.github.io/litsearchr/
3 · Mão na massa
A regra do bloco prático
Todo mundo faz a mesma pergunta, nas mesmas ferramentas, e nós comparamos as listas. O objetivo não é aprender a clicar — é ver com os próprios olhos que as listas não coincidem.
Formule sua pergunta assim (é o formato que as ferramentas semânticas respondem melhor):
Uma frase completa, com o organismo, o processo e o contexto. Ex.: “How do larval density and predator cues jointly affect tadpole morphology in temporary ponds?”
Não use uma string booleana aqui. Essas ferramentas não são buscadores booleanos, e dar a elas uma sintaxe que elas não interpretam é a forma mais fácil de obter um resultado ruim e culpar a ferramenta.
Ferramenta A · Consensus
Como ela busca: abordagem híbrida — busca semântica por embeddings combinada com busca por palavra-chave (BM25), sobre um corpus agregado de Semantic Scholar + OpenAlex + crawl próprio, “over 200 million academic papers”.
O que ela devolve: artigos + uma extração de “afirmações” (claims), com um medidor de quanto a literatura recuperada concorda.
Além da busca padrão, dois modos agênticos — é aqui que o resultado muda de verdade:
| Modo | O que ele faz a mais |
|---|---|
| Pro | quebra a pergunta em sub-buscas, aplica filtros, percorre o grafo de citações e compõe uma resposta ancorada nas fontes |
| Deep Search | até 20 buscas em paralelo, ferramentas de agente como rastreio de citações, e 50 a 100 artigos lidos antes de responder |
Para o exercício, rode a busca padrão — é ela que compara de igual para igual com o Undermind. Mas vale saber que a mesma pergunta em modo Deep devolve outra lista: o modo é parte do método e precisa ser declarado junto com a ferramenta.
O medidor de consenso sintetiza o que foi recuperado, não a literatura — se a recuperação for enviesada, ele mostra um consenso que não existe. E o algoritmo de ranqueamento não é publicado: não dá para auditar por que um artigo ficou em primeiro e outro em décimo.
Descrição dos modos conforme a documentação da própria Consensus: https://docs.consensus.app/get-started/how-search-works
Ferramenta B · Undermind
Como ela busca: busca agêntica iterativa — faz perguntas de esclarecimento, lê e avalia centenas de artigos, segue cadeias de citação, e repete até convergir. É um desenho diferente: otimiza sensibilidade em vez de velocidade (uma busca leva minutos, não segundos).
O que a empresa declara, num benchmark interno de 23 consultas contra GPT-5.6 e Claude Opus 5: 85% de recall nos 20 artigos mais relevantes, 75% no conjunto total, 58% de precisão.
Esses números são autodeclarados e não passaram por revisão por pares. O conjunto de referência é da própria empresa. Cite-os como alegação do fabricante, nunca como resultado.
https://www.undermind.ai — dados do material promocional da empresa, consultado em setembro de 2026.
Exercício 1 · a mesma pergunta, duas ferramentas 20 min
Passo a passo
- Rode a mesma pergunta nas duas. No Consensus use a busca padrão.
- Pegue os 10 primeiros de cada uma — só o primeiro autor e o ano, não precisa copiar DOI.
- Conte quantos aparecem nas duas listas. É um número de 0 a 10.
- Se você trouxe uma revisão sua: quantas das referências que você sabe que são relevantes apareceram? Essa é a sua sensibilidade estimada.
Escreva o seu número no quadro. Vinte pessoas, vinte números: é a nossa pequena amostra, e ela vale mais que qualquer slide que eu mostre a seguir.
O que esperamos que aconteça
A sobreposição vai ser baixa. E cada lista vai conter artigos relevantes que a outra não tem.
Isso tem duas leituras, e as duas são verdadeiras:
Leitura pessimista
Se duas ferramentas sobre bases parecidas discordam tanto, nenhuma das duas está recuperando o conjunto relevante. Você não tem como saber o que ficou de fora.
Leitura otimista
Cada uma acha coisas que a busca booleana tradicional não acharia. Como complemento, elas aumentam a cobertura.
E é exatamente isso que a literatura encontra. Lahlou et al. (2026), na LSE, produziram seis revisões de literatura assistidas por IA a partir do mesmo corpus de 280 artigos e mediram apenas 20% de sobreposição entre a seleção humana e a do LLM.
Lahlou S, Gouttebroze A, Oraee A, Madera J (2026). Writing literature reviews with AI: principles, hurdles and some lessons learned. arXiv:2603.20235 — preprint, não revisado por pares.
Em que estágio o LLM é bom — e em qual não é
Scherbakov et al. (2025) revisaram 172 estudos de automação de revisão com LLM e compilaram as métricas reportadas por estágio. À esquerda, modelos tipo GPT; à direita, tipo BERT.
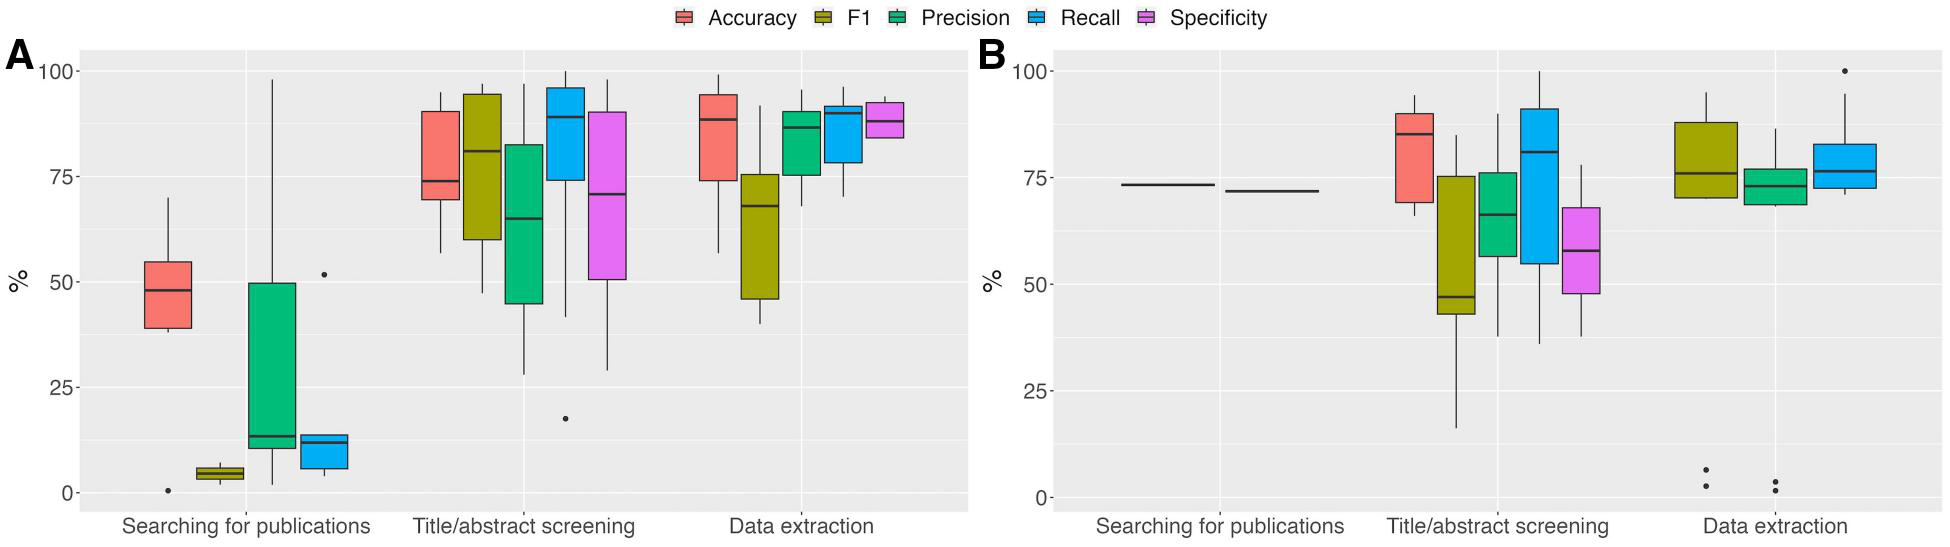
Leia o primeiro grupo de cada painel. “Searching for publications” tem F1 e recall perto do chão, enquanto triagem e extração ficam entre 70% e 90%. Os próprios autores explicam: “The relatively low result in searching for publications can be attributed to high hallucination rates, when these models are prompted to generate scientific citations.”
Fig. 6 de Scherbakov D, Hubig N, Jansari V, Bakumenko A, Lenert LA (2025), J Am Med Inform Assoc 32:1071–1086, doi:10.1093/jamia/ocaf063. Reproduzida sem alterações sob CC BY-NC 4.0.
O que essa figura resolve para você
O estágio em que o LLM é pior é exatamente aquele que os tutoriais da internet mais anunciam. “Use IA para achar artigos” é a pior aplicação possível; “use IA para triar e extrair dados dos artigos que você achou” é a melhor.
Isso reorganiza o fluxo inteiro:
| Estágio | Quem faz | Por quê |
|---|---|---|
| Formular a pergunta e os critérios | humano | é a decisão científica |
| Construir a busca | humano + base (booleana, litsearchr, OpenAlex) |
precisa de sensibilidade e de ser reexecutável |
| Ampliar com sementes | IA (Consensus, Undermind) | alta precisão ajuda aqui |
| Triagem de título/resumo | IA supervisionada (ASReview) | 70–90% e escala |
| Extração de dados | IA supervisionada | o melhor desempenho medido |
| Síntese e interpretação | humano | é o artigo |
A medida que resolve a discussão
Lau & Golder (2025) compararam o Elicit Pro (modo Review) com as buscas tradicionais de quatro sínteses de evidência já publicadas — duas delas revisões Cochrane:
| Elicit | Busca tradicional | |
|---|---|---|
| Sensibilidade (achou os estudos incluídos) | 39,5% (25,5–69,2) | 94,5% (91,1–98,0) |
| Precisão (do que trouxe, quanto prestava) | 41,8% (35,6–46,2) | 7,55% (0,65–14,7) |
“At the time of this evaluation, Elicit did not search with high enough sensitivity to replace traditional literature searching. However, the high precision of searching in Elicit could prove useful for preliminary searches, and the unique studies identified mean that Elicit can be used by researchers as a useful adjunct.”
Lau O, Golder S (2025). Comparison of Elicit AI and Traditional Literature Searching in Evidence Syntheses Using Four Case Studies. Cochrane Evidence Synthesis and Methods 3(6). doi:10.1002/cesm.70050 — CC BY, acesso aberto
Leia a tabela como estatístico, não como usuário
As ferramentas de IA invertem o compromisso clássico da busca sistemática: trocam sensibilidade por precisão.
A busca booleana tradicional é deliberadamente sensível e imprecisa — traz 4.000 títulos para você achar 30, porque em revisão sistemática o custo de um falso negativo é muito maior que o de um falso positivo. Você nunca vai saber o que perdeu.
A ferramenta de IA faz o contrário: entrega 20 itens dos quais 8 prestam. Ótimo para começar. Fatal se for a busca final.
Regra operacional: sensibilidade de ~40% é inaceitável para uma revisão sistemática e perfeitamente aceitável para um levantamento exploratório. A ferramenta não é boa nem ruim — ela tem um perfil, e o perfil precisa casar com a tarefa.
A mesma tabela, desenhada
O apelo da barra de baixo é real: ninguém quer ler 1.258 títulos. O preço está na linha vermelha.
Diagrama original · CC BY 4.0. Números arredondados a partir das médias de Lau & Golder (2025), aplicados a um conjunto hipotético de 100 relevantes.
E o problema mais sério: reprodutibilidade
Vera et al. (2025) compararam um sistema com humano no circuito contra Scite, Consensus e Perplexity:
“Results showed that through an iterative human-in-the-loop approach, NeuroLit Navigator produced more precise and focused search strategies aligned with domain-specific terminologies compared to commercial LLM-based systems, which presented issues such as lack of reproducibility and interpretability.”
Uma consulta booleana é um objeto: colável no Methods, reexecutável em 2031, auditável por um parecerista. Uma sessão agêntica é um evento: acontece uma vez e não volta.
Isso tem consequência editorial direta: o PRISMA-S (e o ROSES, na nossa área) pede a estratégia de busca completa, por base, com data. “Busquei no Undermind em março” não satisfaz esse item.
Vera V, Khandelwal V, Roy K, Garimella R, Surana H, Sheth A (2025). AI-Augmented Search for Systematic Reviews: A Comparative Analysis. Proc Assoc Inf Sci Technol 62(1):705–717. doi:10.1002/pra2.1290
Como fica quando se faz direito
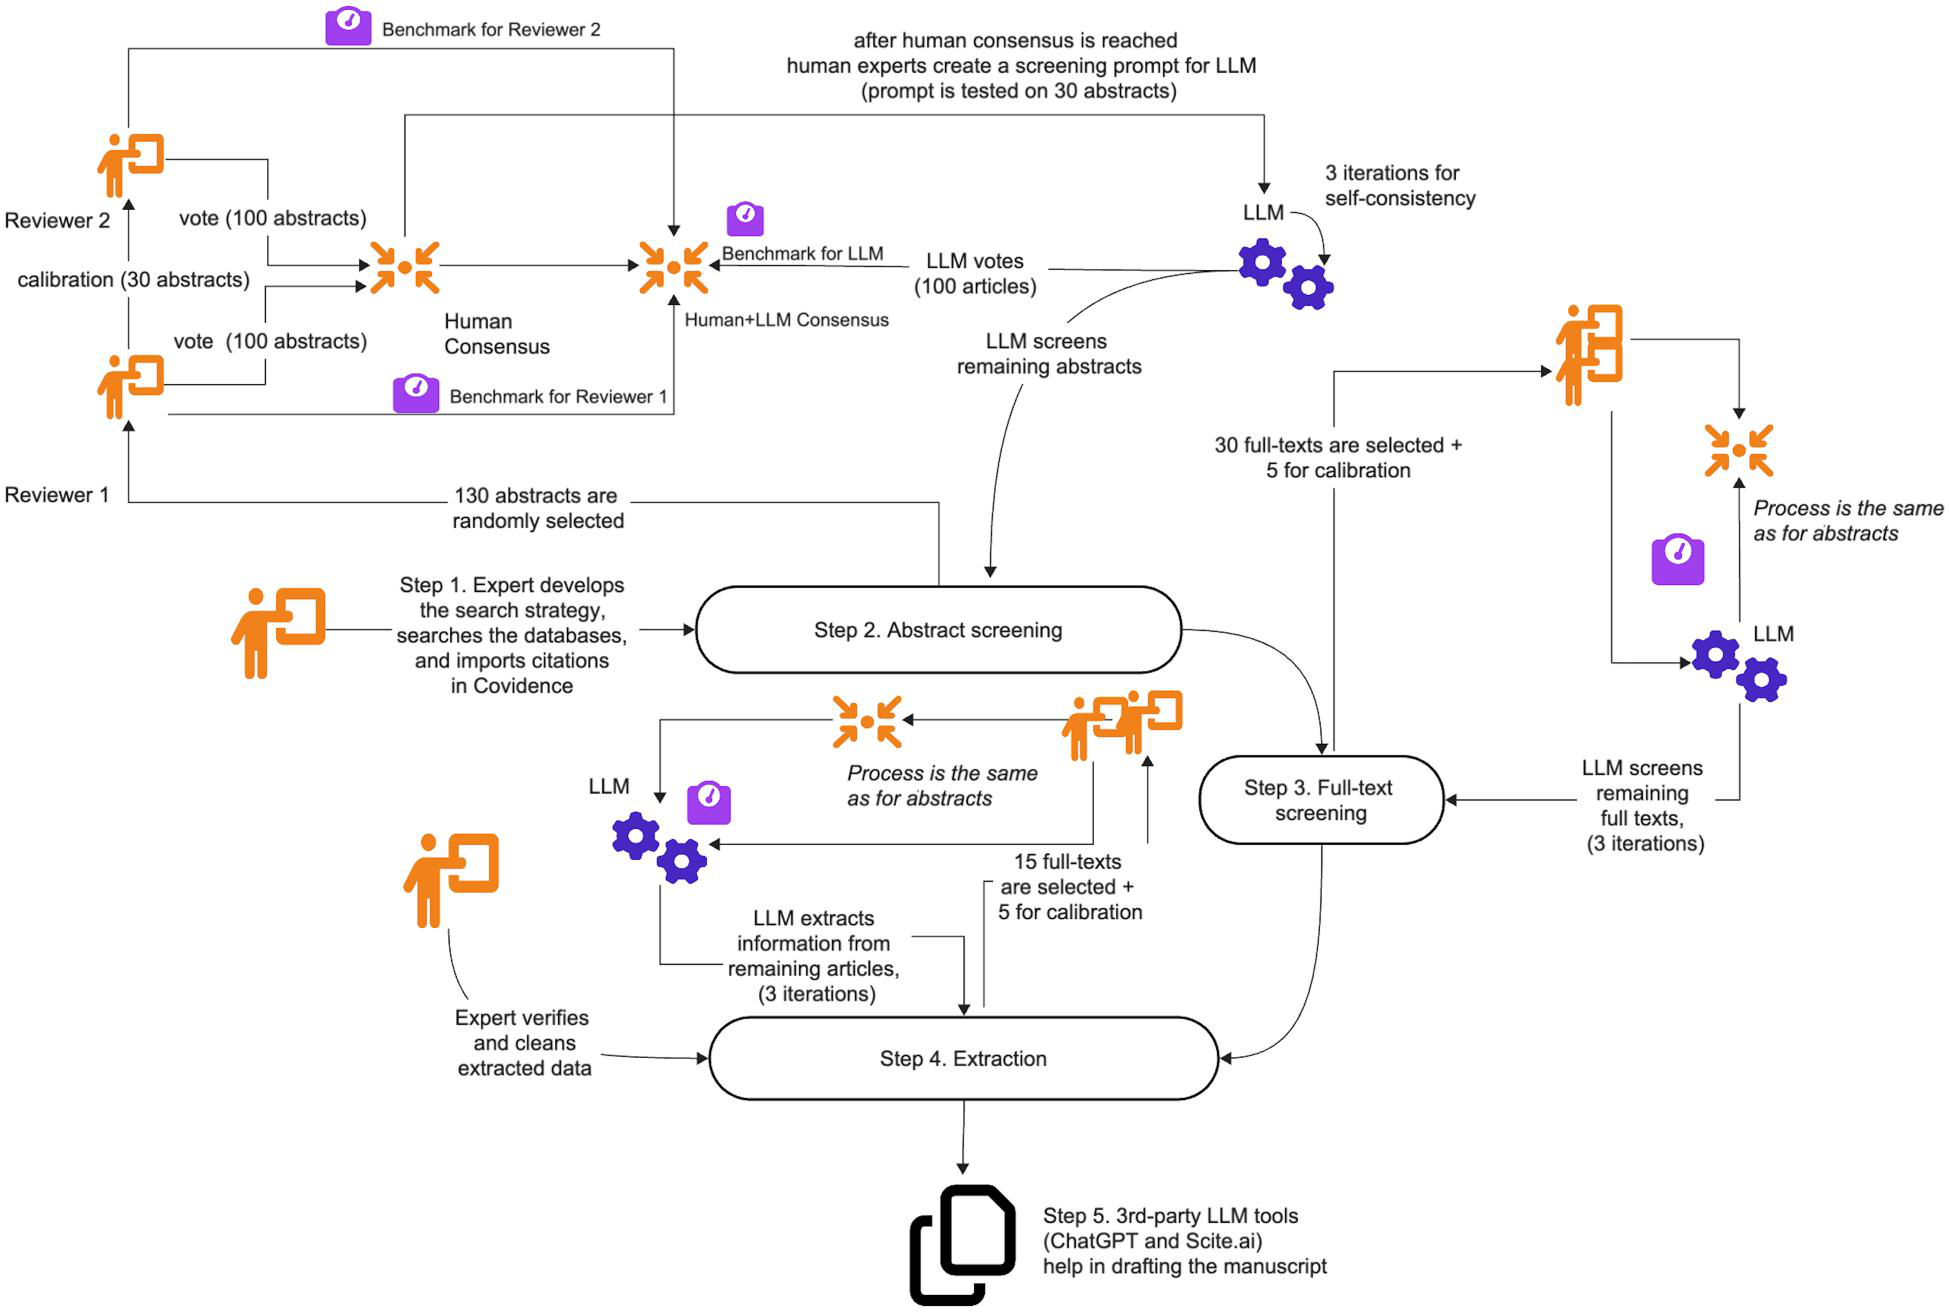
Fig. 1 de Scherbakov et al. (2025), J Am Med Inform Assoc 32:1071–1086, doi:10.1093/jamia/ocaf063. Reproduzida sem alterações sob CC BY-NC 4.0.
O detalhe que salta da figura
Passo 1 — “Expert develops the search strategy, searches the databases, and imports citations” — é humano. Numa das revisões sistemáticas assistidas por LLM mais ambiciosas já publicadas, a busca continuou sendo feita por uma pessoa.
O resto da figura é a arquitetura que torna o uso defensável:
- cada etapa do LLM é calibrada contra um consenso humano numa amostra (30 resumos), com benchmark medido para os humanos e para o modelo;
- o LLM vota 3 vezes e decide por maioria (autoconsistência), porque a saída não é determinística;
- categorias com precisão abaixo de 80% voltam para revisão manual;
- e há um número reportado no fim: precisão média de 83,0% e recall de 86,0% na extração de dados.
Nada disso é “pedir pro ChatGPT fazer a revisão”. É engenharia de processo, com medição em cada junta — e com a etapa de busca deliberadamente fora do escopo.
Exercício 2 · a mesma pergunta, agora em R 10 min
Passo a passo
- Traduza sua pergunta numa consulta do
openalexR(use o bloco do slide anterior como molde). - Rode e conte quantos registros vieram.
- Compare com os 10 do Consensus: quantos deles estão no resultado do OpenAlex?
- Salve o script. Esse script é o seu Methods.
Não tem R funcionando? Faça pela web. O https://openalex.org tem busca e filtros na interface, e exporta CSV. Você perde a reexecução automática, mas faz o exercício inteiro e enxerga a mesma coisa — e a URL da busca já é um registro melhor do que “busquei no Consensus”.
O ponto do exercício não é que o R ache mais coisa. É que o resultado do R é reexecutável — e os outros dois não são.
As outras ferramentas, e onde cada uma entra
| Ferramenta | O que é, de verdade | Quando usar |
|---|---|---|
| Scholar Gateway | busca semântica sobre corpus de texto completo (Wiley) | quando o argumento está no corpo do artigo, não no resumo |
| LeapSpace | espaço de trabalho de IA da Elsevier | se sua instituição assina; herda a cobertura Scopus |
| Scite | contexto de citação: quem cita apoiando, contestando ou só mencionando | checar se aquele clássico foi contestado depois |
| NotebookLM | não busca nada — conversa com o seu acervo: você sobe os PDFs e ele responde ancorado só neles, com citação de trecho | depois da busca: resumir os artigos que você baixou, cruzar o que eles dizem entre si, e interrogar o conjunto |
O NotebookLM é a etapa seguinte, e é onde ele é muito bom. Terminada a busca, você tem 40 PDFs baixados. Subir esse acervo e perguntar a ele — quais destes usam delineamento experimental?, onde eles discordam sobre o efeito da densidade?, qual a faixa de tamanho amostral? — é leitura assistida sobre um corpus que você escolheu, com cada resposta apontando o trecho de origem. Isso resolve o mecanismo A do bloco 1: não há o que inventar, porque a fonte está no seu disco.
O que ele não é: ferramenta de busca. Todo tutorial da internet o coloca nessa lista. Usá-lo para “achar literatura” garante que você só encontra o que já tinha — ele não conhece nada além do que você subiu.
Um guia aberto, escrito por ecólogos
Matthew Grainger e Frode Thomassen Singsaas, do NINA (Norsk institutt for naturforskning), mantêm um guia vivo sobre IA em busca e triagem para sínteses de evidência em ecologia e meio ambiente.
As recomendações centrais:
- Validar toda saída de IA com julgamento humano
- Documentar tudo — ferramenta, versão, parâmetros, método de validação
- Priorizar sensibilidade sobre precisão na triagem
- Avaliar viés, em especial contra literatura cinzenta e não anglófona
- Preferir ferramentas abertas, por equidade e reprodutibilidade
Ferramentas que ele indica: ASReview (triagem por aprendizado ativo, aberta), Rayyan, Colandr, revtools (deduplicação em R).
Grainger M, Singsaas FT. Guide to Using AI in Literature Searching and Screening for Evidence Syntheses, v0.2 (documento vivo), NINA. https://ninanor.github.io/AI_review_guide/
4 · Demonstração · agente + MCP
Custo e acesso: o Sul global paga duas vezes
Primeira vez — no bolso
Consensus, Undermind, Elicit Pro, LeapSpace, Scite: assinatura em dólar, em país onde a bolsa de doutorado é o que é. A assimetria de acesso a ferramenta vira assimetria de produtividade aparente.
Segunda vez — nos dados
Lembre do bloco 1: a alucinação passou de 80% para publicações de países de baixa renda. A literatura do Sul é a que os modelos conhecem pior — e portanto a que eles mais inventam e menos recuperam.
O resultado combinado é um ciclo: a literatura menos indexada é menos recuperada, logo menos citada, logo menos indexada. A ferramenta não criou o viés — mas automatiza e acelera ele.
O outro lado, que seria desonesto omitir
Amano et al. pesquisaram 908 pesquisadores de oito nacionalidades: quem não é falante nativo de inglês gasta muito mais tempo lendo, escrevendo e preparando apresentações, e tem mais artigos rejeitados ou devolvidos por causa da escrita, independentemente da qualidade da ciência. Turchini (2026) tira daí a conclusão que nos interessa: “AI, in reducing the language barrier, may end up accelerating scientific progress itself, not just individual careers.”
Ou seja: a mesma tecnologia que amplifica o viés de recuperação reduz a barreira de língua. As duas coisas são verdadeiras ao mesmo tempo, e quem apresenta só uma delas está fazendo propaganda.
O que está na nossa mão: usar e sustentar infraestrutura aberta (OpenAlex, ASReview, openalexR), depositar nossos próprios trabalhos com DOI e metadados decentes, e não tratar “não apareceu na busca” como “não existe”.
Amano T, Ramírez-Castañeda V, Berdejo-Espinola V et al. (2023). The manifold costs of being a non-native English speaker in science. PLoS Biology 21(7):e3002184. doi:10.1371/journal.pbio.3002184 · citado em Turchini (2026), doi:10.1111/raq.70196
O que você vai ver (e o que não vai poder repetir hoje)
Aviso honesto, e é por isso que o slide anterior veio primeiro: esta parte usa ferramenta paga. É demonstração, não exercício. Mostro porque é para onde o fluxo está indo — e porque o protocolo por baixo é aberto, ainda que o cliente não seja.
O que é um MCP: um padrão aberto que expõe uma ferramenta externa — uma base bibliográfica, um sistema de arquivos, um repositório — de um jeito que o modelo consegue chamar sozinho, decidindo quando e com quais parâmetros.
Na prática: em vez de eu buscar no Consensus, copiar os resultados e colar no chat, o modelo chama o Consensus e recebe os metadados estruturados — com DOI de verdade, vindo da base.
O prompt
Preciso de um levantamento exploratório sobre plasticidade fenotípica
induzida por predador em girinos de anuros neotropicais.

1. Busque no Consensus e no Scholar Gateway, separadamente.
2. Para cada base, liste os 15 artigos mais relevantes com DOI.
3. Marque quais aparecem nas DUAS listas e quais são exclusivos.
4. Para cada DOI, confirme que ele resolve. Descarte os que não resolverem
   e me diga quantos foram descartados.
5. Aponte o que as duas listas NÃO cobrem: períodos, regiões, idiomas.
6. Ao final, escreva o parágrafo de Methods descrevendo exatamente o que
   você fez, com as datas das consultas.
Os itens 4, 5 e 6 são o que separa isto de “pedir referências pro ChatGPT”. Sem eles, você voltou ao mecanismo A do bloco 1.
O que observar durante a demonstração
A favor
- Os DOIs vêm da base, não do modelo
- A verificação é explícita e contável
- O passo 5 força uma declaração de limitação
- O passo 6 produz o texto do Methods
Contra
- A consulta exata que o agente mandou não fica registrada por padrão
- Repetir o prompt amanhã dá outro resultado
- Custa dinheiro; escala com o uso
- Concentração: poucas empresas, no Norte
Se for usar isto em trabalho publicado: guarde a transcrição inteira da sessão como material suplementar. É o mais perto de reprodutibilidade que dá para chegar aqui — e ainda assim não é reprodutibilidade.
5 · Fechamento
Modelos abertos, rodando na sua máquina
Há hoje modelos de pesos abertos publicados por grupos chineses — Qwen (Alibaba), DeepSeek, Kimi (Moonshot AI) — que podem ser baixados e executados localmente (Ollama, LM Studio, llama.cpp).
O que isso resolve: custo marginal zero, dado que não sai da sua máquina, funciona sem internet, e independe de uma empresa manter o serviço no ar.
O que isso não resolve:
- Modelos de tamanho de fronteira não cabem num laptop. O que cabe num equipamento de 48 GB de memória unificada são versões menores e/ou quantizadas — e quantização troca qualidade por memória.
- Um modelo local continua sendo o mecanismo A do bloco 1. Rodar offline não faz ele parar de inventar DOI. Para revisão de literatura, o que importa é a base, não onde o modelo roda.
Não vou mostrar ranking de benchmark. As posições mudam de mês e as avaliações públicas são contestadas e frequentemente autodeclaradas pelos fabricantes — vale aqui a mesma crítica que fizemos ao número do Undermind.
O pesquisador do futuro?
Em maio de 2026 a Nature publicou o Co-Scientist, um sistema multiagente sobre o Gemini que gera, critica e refina hipóteses — validado em três aplicações biomédicas, com confirmação experimental in vitro em duas.
Leia o que o artigo de fato mostra. Ele mostra geração de hipóteses com validação experimental por humanos em domínios biomédicos muito bem caracterizados. Ele não mostra revisão de literatura automatizada, nem generaliza para ecologia de campo, nem dispensa o experimento.
A pergunta interessante não é “a IA vai substituir o pesquisador”. É: se gerar hipóteses ficou barato, o que fica caro? Provavelmente: decidir qual pergunta vale a pena, desenhar o estudo que a responde, e ter o sistema de estudo na mão.
Gottweis J, Weng W-H, Natarajan V et al. (2026). Accelerating scientific discovery with Co-Scientist. Nature 655:487–496. doi:10.1038/s41586-026-10644-y · Para o panorama mais amplo do efeito dos GPTs sobre o ecossistema acadêmico — recuperação de conhecimento, escrita por não nativos, triagem editorial — ver Cai Y, Deng Q, Lv T, Zhang W, Zhou Y (2025). Impact of GPT on the Academic Ecosystem. Science & Education. doi:10.1007/s11191-024-00561-9
Como declarar uma busca assistida por IA
Fecha o circuito com a palestra anterior. No AIdIT, busca de literatura cai em Conceitualização (revisão de literatura) e Redação (identificar literatura a citar). Em termos práticos, o parágrafo precisa ter:
| Item | Exemplo |
|---|---|
| Ferramenta e versão | Consensus (acesso web), Undermind v2 |
| Data da consulta | 14/10/2026 |
| Base subjacente | Semantic Scholar + OpenAlex |
| A consulta literal | a frase exata, em anexo |
| O que a IA fez | busca exploratória e identificação de sementes |
| O que o humano fez | busca booleana final, triagem, verificação de todos os DOIs |
| Verificação | n referências conferidas contra CrossRef; n descartadas |
Se a ferramenta foi usada só para achar sementes e a busca final foi booleana e reprodutível, diga isso. É uma descrição forte, não uma confissão.
A receita, em uma página
Fotografe este slide. É o workshop inteiro em nove linhas.
| # | Etapa | Com o quê | O que registrar |
|---|---|---|---|
| 1 | Pergunta e critérios de inclusão | você, antes de abrir qualquer ferramenta | o texto dos critérios |
| 2 | Sementes (10–20 artigos) | Consensus / Undermind, busca padrão | ferramenta, modo, data |
| 3 | Termos de busca | litsearchr sobre as sementes |
o script |
| 4 | Busca principal | booleana no OpenAlex (openalexR ou web); Scopus/WoS se houver assinatura |
a string e a data |
| 5 | Rastreio de citações | Google Scholar, “Cited by” das sementes | quantas entraram por aqui |
| 6 | Deduplicar e guardar | Zotero (ou revtools no R) |
nº antes e depois |
| 7 | Triagem de título/resumo | ASReview, ou manual com dois revisores | critério de parada |
| 8 | Leitura do acervo | NotebookLM sobre os seus PDFs | nada — é leitura |
| 9 | Parágrafo de Methods | você | tudo das colunas acima |
A etapa 6 é a que todo mundo pula e a que mais dói depois. Sem gerenciador de referências não há revisão — é ali que a lista vira acervo, e é o acervo que alimenta as etapas 7 e 8.
Zotero: https://www.zotero.org · há assistentes de IA que trabalham dentro da sua biblioteca do Zotero — sobre o acervo que você já reuniu, no mesmo espírito do NotebookLM. Uma demonstração recente: Andy Stapleton, I Finally Found an AI That Works Inside Zotero, https://www.youtube.com/watch?v=jc6NqXcObqc
Síntese: cinco regras
- Nenhum LLM sem busca é ferramenta de revisão. Sem recuperação ancorada, ele gera a forma de uma bibliografia.
- Separe os dois mecanismos. Bloqueio de acesso e alucinação têm causas diferentes; confundi-los gera solução errada.
- Combine com o perfil da tarefa. Alta precisão e baixa sensibilidade: ótimo para explorar e achar sementes, inadequado como busca final de revisão sistemática.
- A busca final tem que ser um objeto, não um evento — string booleana ou script, com base e data. É o que PRISMA-S e ROSES pedem.
- Desconfie de concordância entre ferramentas. Se todas buscam no mesmo índice, concordar não é confirmar.
O que a máquina faz bem é ampliar o alcance. O que ela não faz é garantir a cobertura — e cobertura é o que uma revisão promete ao leitor.
Voltando ao editorial do começo, que fecha melhor do que eu conseguiria:
Reviews are not made redundant by AI. They are redefined by it.
Obrigado
Diogo B. Provete
Instituto de Biociências, UFMS
Biodiversity Synthesis Lab
Slides, código-fonte e todas as referências deste workshop estão no repositório vinculado a esta página.
Para continuar
Ferramentas e documentação
- OpenAlex — https://openalex.org
- openalexR — https://docs.ropensci.org/openalexR/
- litsearchr — https://elizagrames.github.io/litsearchr/
- ASReview — https://asreview.nl
- Zotero — https://www.zotero.org
- Search Smart (comparador de bases) — https://www.searchsmart.org
- Guia do NINA — https://ninanor.github.io/AI_review_guide/
- Cloudflare Radar — https://radar.cloudflare.com/bots/br
Canais
- David Stuckler — https://www.youtube.com/@profdavidstuckler
- Andy Stapleton — https://www.youtube.com/@DrAndyStapleton
- Mano Deyvin (IA na prática e geopolítica) — https://www.youtube.com/@manodeyvin
- Código Fonte TV — https://www.youtube.com/@codigofontetv
- Maestros da IA — https://www.youtube.com/@maestrosdaia
Referências
Desempenho e confiabilidade das ferramentas
- Culbert JH, Hobert A, Jahn N, Haupka N, Schmidt M, Donner P, Mayr P (2025). Reference coverage analysis of OpenAlex compared to Web of Science and Scopus. Scientometrics. doi:10.1007/s11192-025-05293-3
- Scherbakov D, Hubig N, Jansari V, Bakumenko A, Lenert LA (2025). The emergence of large language models as tools in literature reviews: a large language model-assisted systematic review. J Am Med Inform Assoc 32(6):1071–1086. doi:10.1093/jamia/ocaf063
- Kim E, Kipchumba F, Min S (2025). Geographic Variation in LLM DOI Fabrication. Publications 13(4):49. doi:10.3390/publications13040049
- Lau O, Golder S (2025). Comparison of Elicit AI and Traditional Literature Searching in Evidence Syntheses Using Four Case Studies. Cochrane Evidence Synthesis and Methods 3(6). doi:10.1002/cesm.70050
- Seifi A, Seyfi A (2026). Hallucination Rate of Peer-Reviewed Citations Generated by Large Language Models in Neurocritical Care. Crit Care Explor 8(9):e1474. doi:10.1097/CCE.0000000000001474
- Ülkir M, Paslı B (2026). Reference Hallucination, Citation Reliability, and Readability of Large Language Models in Anatomy-Related Question Answering. Clin Anat. doi:10.1002/ca.70187
- Vera V, Khandelwal V, Roy K, Garimella R, Surana H, Sheth A (2025). AI-Augmented Search for Systematic Reviews: A Comparative Analysis. Proc Assoc Inf Sci Technol 62(1):705–717. doi:10.1002/pra2.1290
- Zhao Z, Wang Y, Stuart T, De Vaan M, Ginsparg P, Yin Y (2026). LLM hallucinations in the wild: Large-scale evidence from non-existent citations. arXiv:2605.07723 — preprint
- Lahlou S, Gouttebroze A, Oraee A, Madera J (2026). Writing literature reviews with AI: principles, hurdles and some lessons learned. arXiv:2603.20235 — preprint
Referências
Métodos e ferramentas
- Aria M, Le T, Cuccurullo C, Belfiore A, Choe J (2024). openalexR: An R-Tool for Collecting Bibliometric Data from OpenAlex. The R Journal 15(4):167–180.
- Grames EM, Stillman AN, Tingley MW, Elphick CS (2019). An automated approach to identifying search terms for systematic reviews using keyword co-occurrence networks. Methods Ecol Evol 10:1645–1654. doi:10.1111/2041-210X.13268
- Grainger M, Singsaas FT. Guide to Using AI in Literature Searching and Screening for Evidence Syntheses, v0.2. NINA. https://ninanor.github.io/AI_review_guide/
- Gusenbauer M, Haddaway NR (2020). Which academic search systems are suitable for systematic reviews or meta-analyses? Evaluating retrieval qualities of Google Scholar, PubMed, and 26 other resources. Research Synthesis Methods 11(2):181–217. doi:10.1002/jrsm.1378
- Gusenbauer M (2024). Beyond Google Scholar, Scopus, and Web of Science: an evaluation of the backward and forward citation coverage of 59 databases’ citation indices. Research Synthesis Methods 15(5):802–817. doi:10.1002/jrsm.1729
Editorial e equidade
- Turchini GM (2026). Can AI Write Your Next Review? Yes. Does That Make Real Review Articles Redundant? No. Reviews in Aquaculture 18:e70196. doi:10.1111/raq.70196
- Amano T, Ramírez-Castañeda V, Berdejo-Espinola V et al. (2023). The manifold costs of being a non-native English speaker in science. PLoS Biology 21(7):e3002184. doi:10.1371/journal.pbio.3002184
Contexto e perspectivas
- Gottweis J, Weng W-H, Natarajan V et al. (2026). Accelerating scientific discovery with Co-Scientist. Nature 655:487–496. doi:10.1038/s41586-026-10644-y
- Messeri L, Crockett MJ (2024). Artificial intelligence and illusions of understanding in scientific research. Nature 627:49–58. doi:10.1038/s41586-024-07146-0
- Cai Y, Deng Q, Lv T, Zhang W, Zhou Y (2025). Impact of GPT on the Academic Ecosystem. Science & Education. doi:10.1007/s11191-024-00561-9
- Naddaf M, Quill E (01/04/2026). Hallucinated citations are polluting the scientific literature. What can be done? Nature. https://www.nature.com/articles/d41586-026-00969-z
- Stokel-Walker C (14/05/2026). Hallucinated citations highest in social sciences preprints site. Nature. https://www.nature.com/articles/d41586-026-01545-1
- Dead Internet theory — verbete da Wikipédia (fonte terciária, usada só para documentar a origem e a recepção da ideia). https://en.wikipedia.org/wiki/Dead_Internet_theory
- Cloudflare (01/07/2025). Content Independence Day: no AI crawl without compensation! https://blog.cloudflare.com/content-independence-day-no-ai-crawl-without-compensation/
- Tom’s Hardware (04/06/2026), sobre postagem de M. Prince (Cloudflare) de 03/06/2026.
Figuras reaproveitadas
- Fig. 1 e Fig. 6 de Scherbakov et al. (2025), JAMIA, doi:10.1093/jamia/ocaf063 — reproduzidas sem alterações sob CC BY-NC 4.0
- Os três diagramas esquemáticos são originais, sob CC BY 4.0
Estes slides: © Diogo B. Provete, sob CC BY 4.0.
Declaração de uso de IA nesta apresentação
Estes slides foram preparados com apoio de Claude (Anthropic), setembro de 2026, nas etapas de conceitualização (crítica e reestruturação do roteiro), curadoria de dados (busca e verificação das fontes, via Scholar Gateway, PubMed e busca na web) e redação (geração de texto a partir de prompts).
As duas demonstrações do bloco 1 — a casca vazia da Cloudflare Radar e o erro 403 da Wiley — ocorreram de fato durante essa preparação e estão reproduzidas literalmente. Os três diagramas esquemáticos (mecanismos de erro; sensibilidade × precisão; cobertura das bases) foram desenhados para esta apresentação; as duas figuras de Scherbakov et al. (2025) são reproduções sob CC BY-NC 4.0, com a licença original preservada.
Todas as citações literais foram conferidas contra os documentos-fonte; todos os DOIs e URLs foram verificados em registros reais. O autor revisou e editou o conteúdo e assume integral responsabilidade por ele.
Declaração no formato AIdIT (Drobniak et al. 2026, doi:10.1186/s41073-026-00230-1) — estágios Conceptualization, Data curation e Writing, com supervisão e verificação por DBP.
provetelab.org