A árvore e os dados

Aula 1 · Métodos Filogenéticos Comparativos · PPGBA/UFMS

Diogo B. Provete

Hoje

  1. Antes de começar: as leituras
  2. O que é uma filogenia
  3. Como escrever uma árvore
  4. De onde vem a árvore
  5. Como obter uma árvore
  6. Dados de atributos
  7. Desenho de estudos comparativos
  8. A forma da árvore

Onde estamos

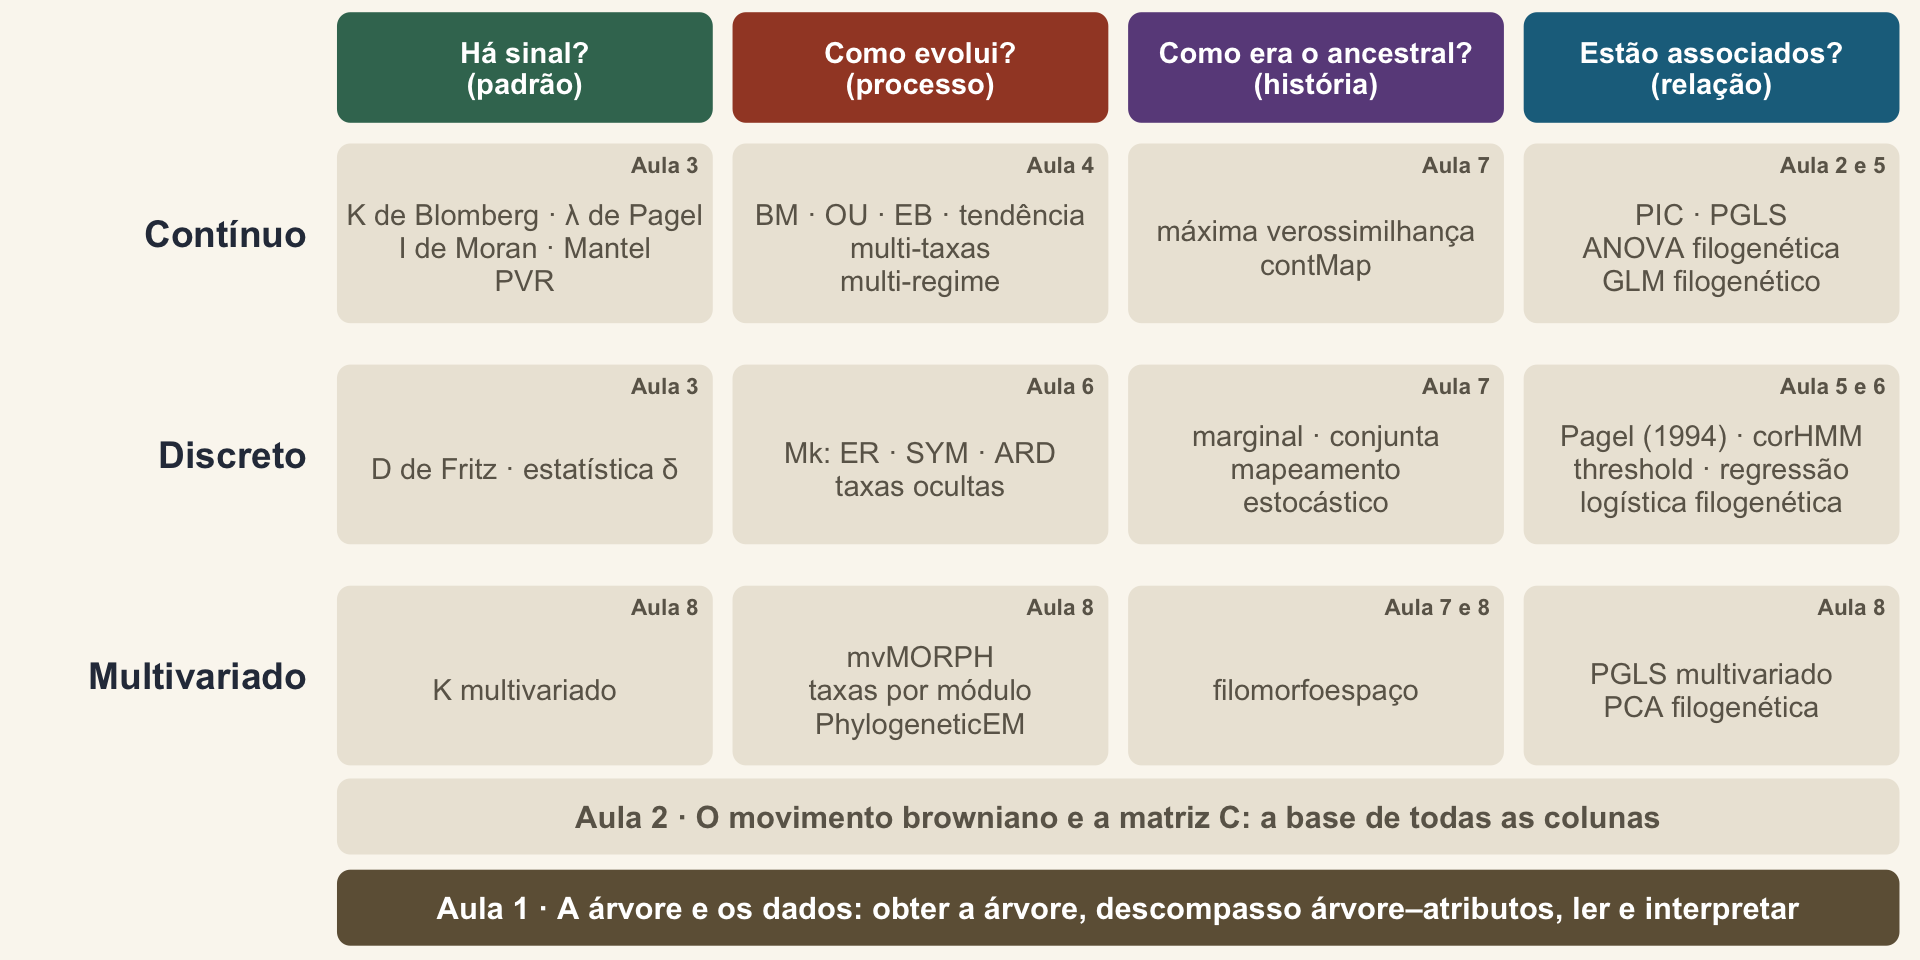
Mapa dos métodos com a faixa de base da Aula 1, a árvore e os dados, destacada sob todas as colunas.

0. Antes de começar: as leituras

A árvore e os dados

Três perguntas, três leituras

  1. Por que espécies não são pontos independentes numa análise?

Porque compartilham ancestrais: parte da semelhança entre elas é herança, não resposta independente ao ambiente (Cornwallis & Griffin 2024).

  1. Que tipos de pergunta os métodos comparativos respondem?

Padrão, processo, história e relação entre atributos (O’Meara 2012).

  1. Como os métodos ajudam a inferir adaptação e mecanismo?

Separando o que é parentesco do que é associação com o ambiente ou com outro atributo (Rezende & Diniz-Filho 2012).

Cornwallis & Griffin (2024), Annu. Rev. Ecol. Evol. Syst. 55: 181–204; O’Meara (2012), Annu. Rev. Ecol. Evol. Syst. 43: 267–285; Rezende & Diniz-Filho (2012), Compr. Physiol. 2: 639–674.

Métodos filogenéticos comparativos

Métodos estatísticos que usam o parentesco entre as espécies para testar hipóteses evolutivas sobre seus atributos. Uma diferença importante: obter uma filogenia × usar uma filogenia.

Perguntas comuns:

  • Qual o padrão filogenético de um atributo?
  • Sob que processo e em que velocidade ele evolui?
  • Qual a correlação dele com outros atributos ou com o ambiente?

O mapa dos métodos (O’Meara 2012) organiza o curso por essas perguntas.

O problema do parentesco comum

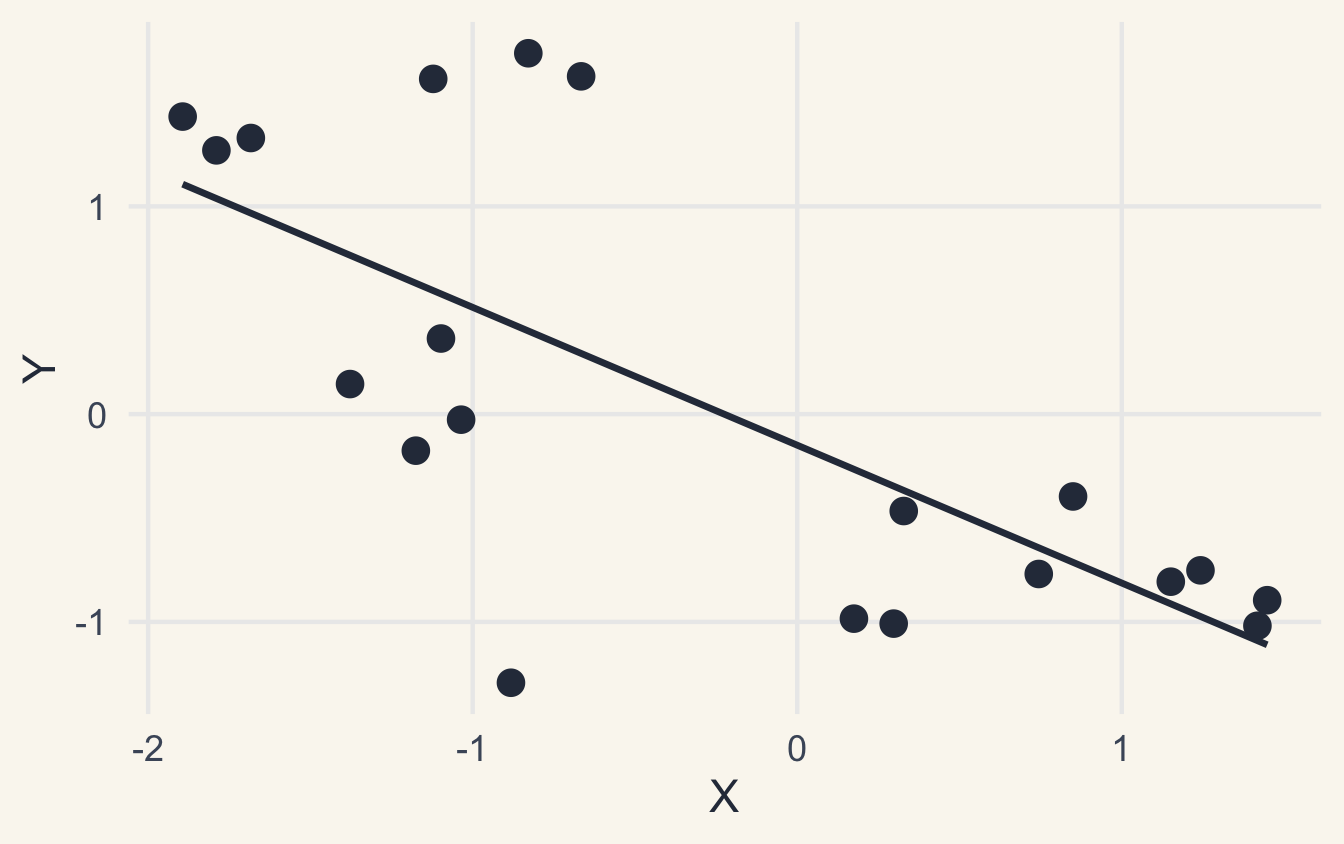
Dispersão de Y contra X em 20 espécies, com uma reta de regressão decrescente forte.

r = -0,72, p < 0,001: X e Y parecem associados.

O problema do parentesco comum
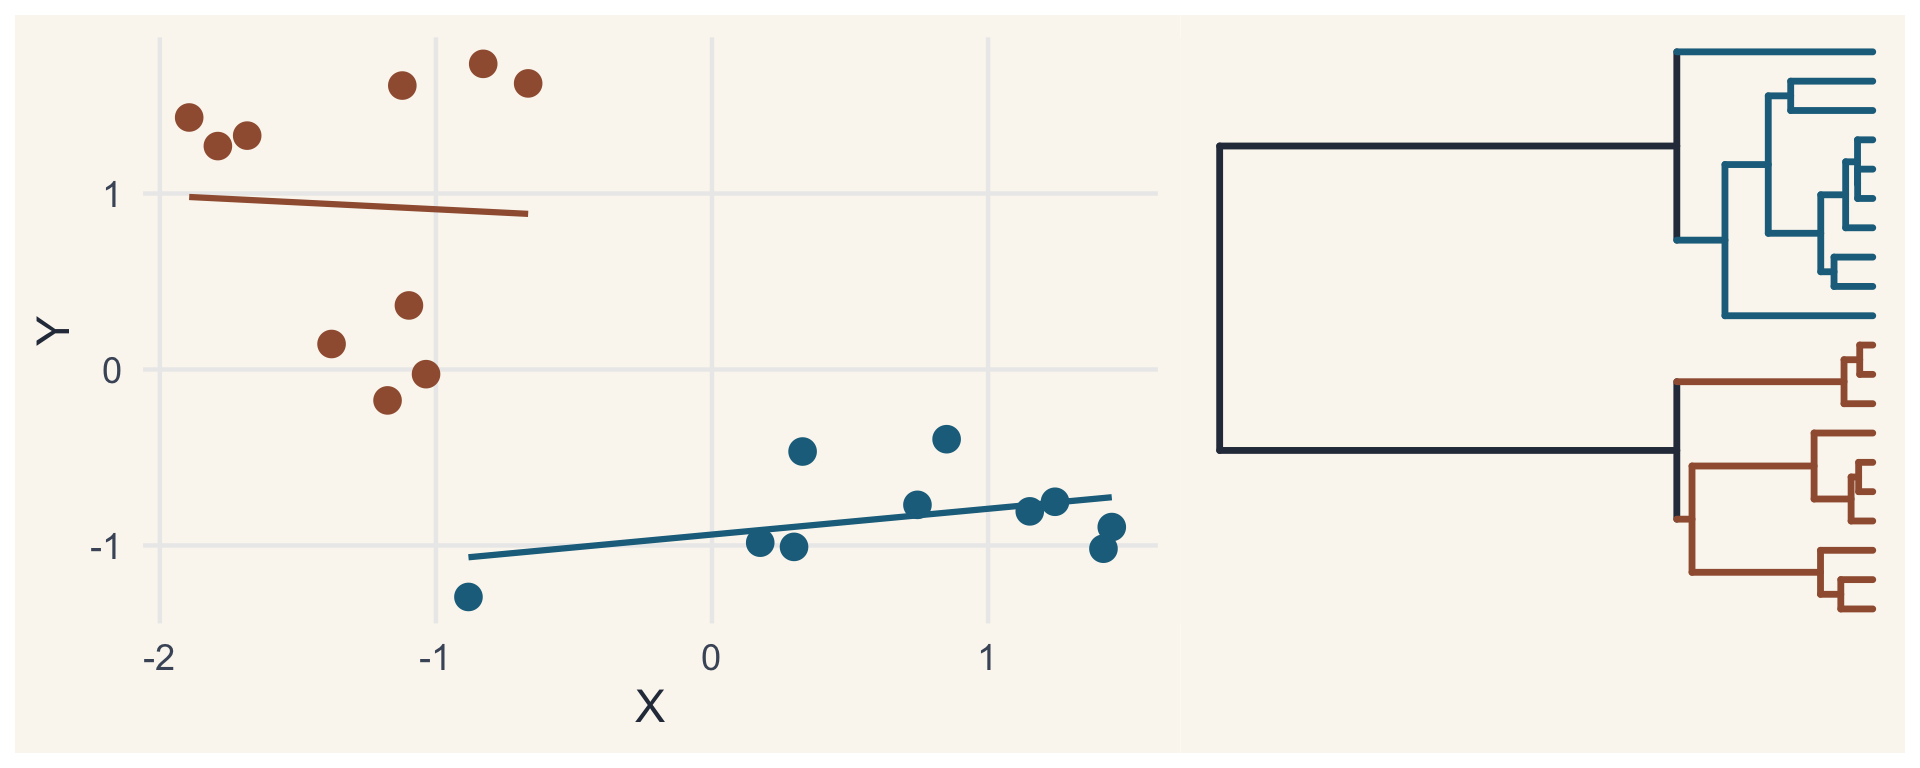
A mesma dispersão com as espécies coloridas por clado, ao lado da árvore: as do clado azul ficam embaixo à direita e as do ferrugem em cima à esquerda; dentro de cada clado, as retas são quase planas.

Mas X e Y foram simulados independentes: a “associação” vem só da diferença entre os dois clados, que se separaram cedo.

Espécies não são independentes
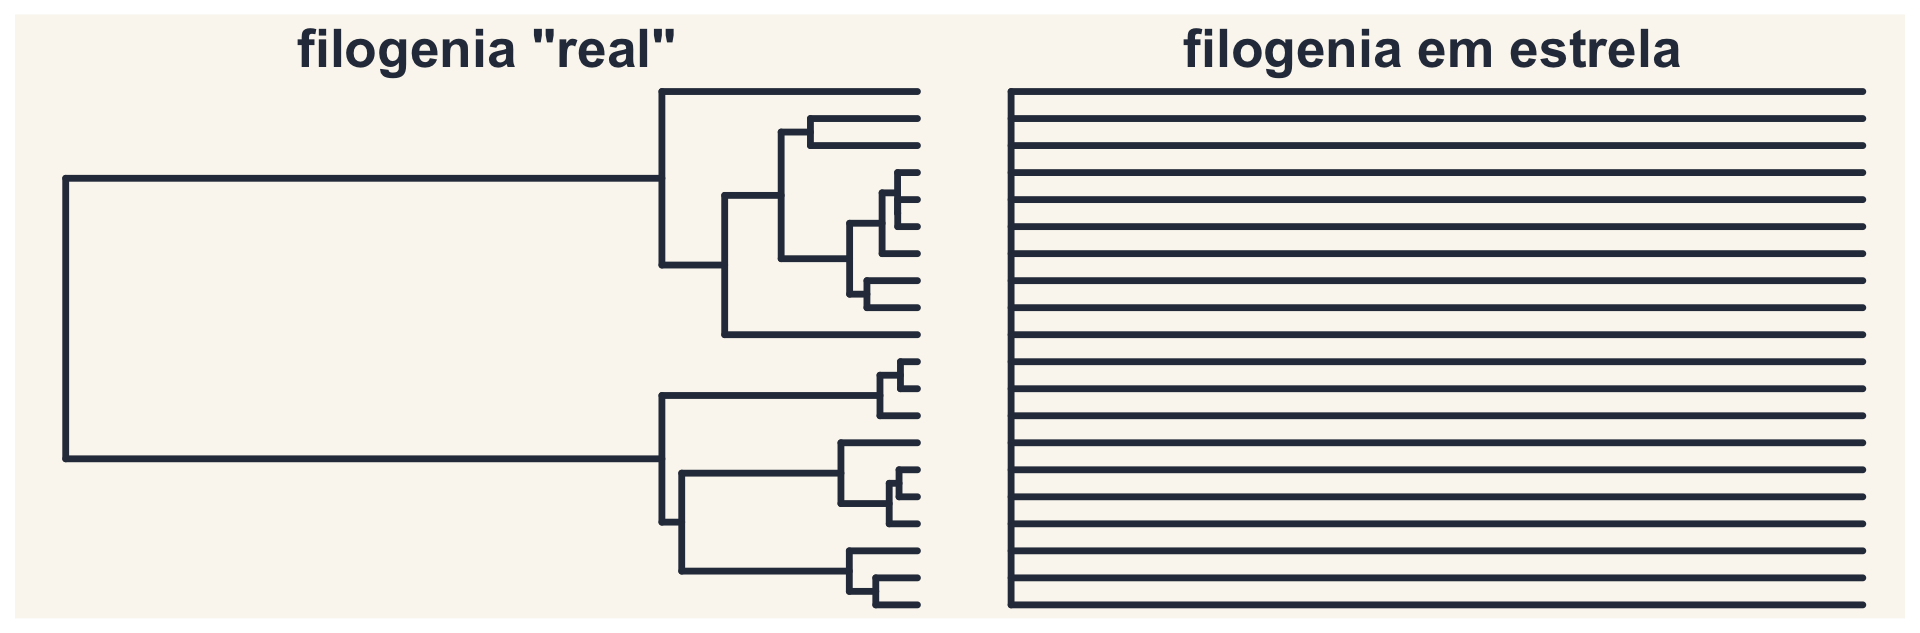
À esquerda, a árvore real com dois clados; à direita, uma filogenia em estrela, em que todas as espécies saem da raiz ao mesmo tempo.

  • Espécies próximas são mais parecidas
  • Tratá-las como independentes (a estrela) infla os graus de liberdade

Uma breve história
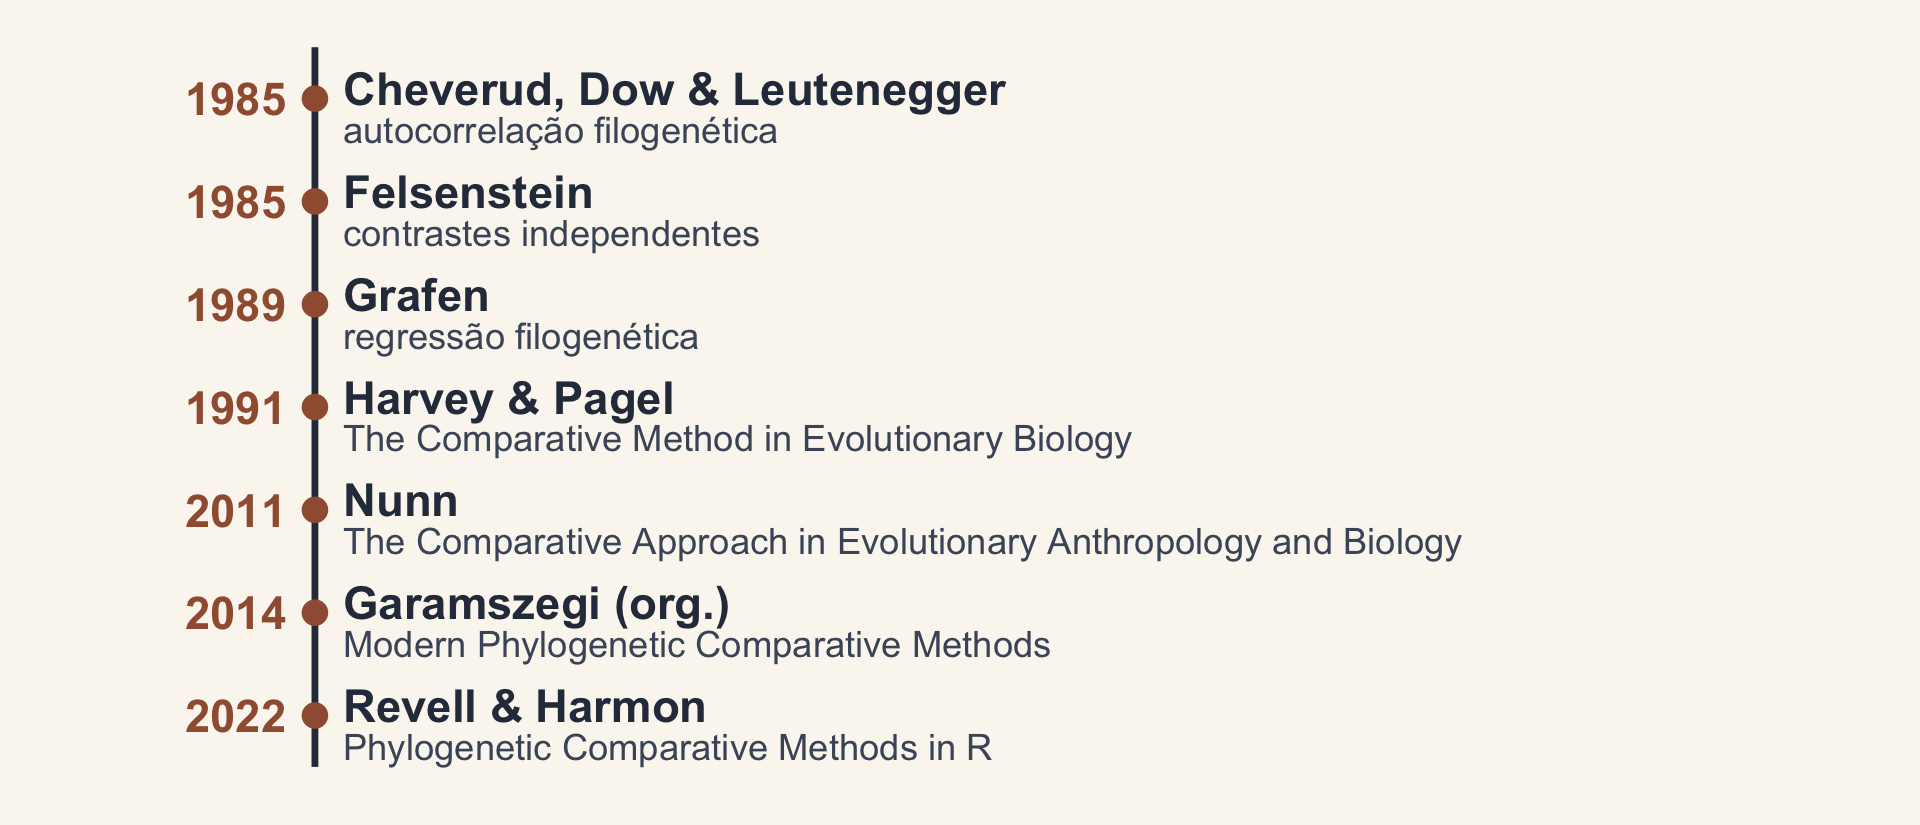
Linha do tempo: Cheverud, Dow e Leutenegger e Felsenstein em 1985, Grafen em 1989, Harvey e Pagel em 1991, Nunn em 2011, Garamszegi em 2014 e Revell e Harmon em 2022.

Cheverud, Dow & Leutenegger (1985); Felsenstein (1985); Grafen (1989); Harvey & Pagel (1991), Oxford University Press; Nunn (2011), University of Chicago Press; Garamszegi (2014), Springer; Revell & Harmon (2022). Curso de Sevilha (2014): mpcm-evolution.com.

Além da biologia: evolução cultural

Pergunta Estudo
Como a Polinésia foi colonizada? Árvore das línguas austronésias Gray, Drummond & Greenhill (2009), Science
A complexidade política sobe e desce aos poucos ou aos saltos? Currie et al. (2010), Nature
Quão antigos são os contos populares indo-europeus? da Silva & Tehrani (2016), R. Soc. Open Sci.
A história cultural prediz mudanças políticas e econômicas das nações? Matthews et al. (2016), PLOS ONE

Os mesmos métodos que vamos usar, aplicados a línguas e culturas.

1. O que é uma filogenia

A árvore e os dados

O que uma filogenia representa?

Relações de parentesco em escalas diferentes:

indivíduos → famílias → populações → espécies

Uma filogenia (entre espécies) é a genealogia em escala de espécies: quem compartilha ancestrais mais recentes com quem. Ver Scitable, Reading a phylogenetic tree.

Da genealogia à filogenia

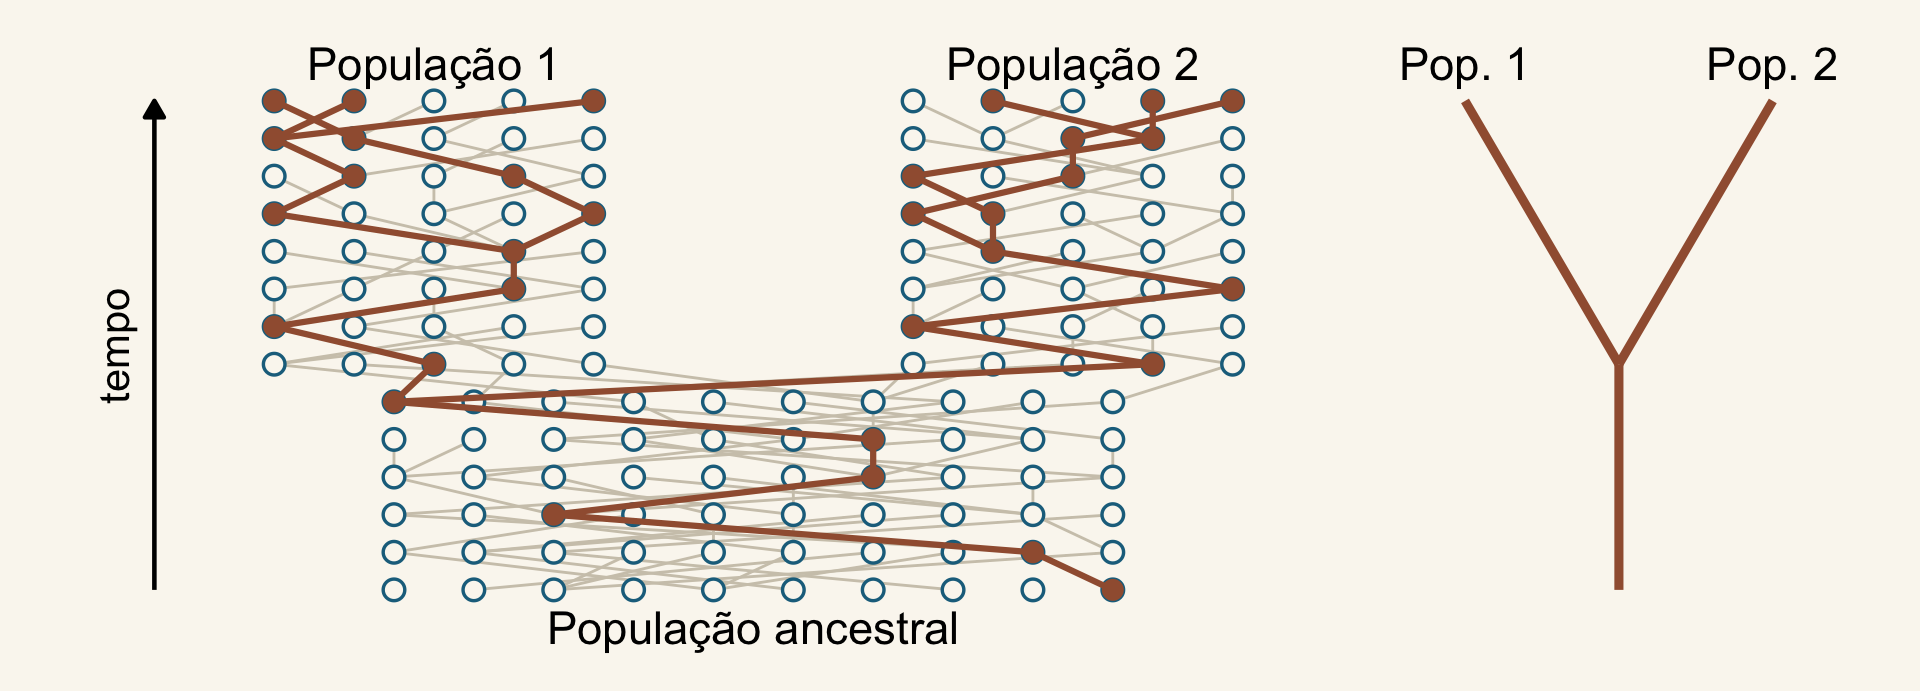
À esquerda, uma genealogia simulada: indivíduos (círculos) de uma população ancestral que se divide em duas, cada um ligado ao pai na geração anterior; as linhagens de três indivíduos amostrados em cada população, em ferrugem, se juntam primeiro dentro da própria população e depois na população ancestral. À direita, a árvore das duas populações.

As linhagens se juntam primeiro dentro de cada população (monofilia recíproca); a árvore das populações resume as genealogias.

Simulação de Wright-Fisher. Ideia do painel A da Fig. 5.5 de Introduction to Population Genetics (Sinauer, 2013), reproduzida por S. Carr, Memorial University.

Partes de uma árvore
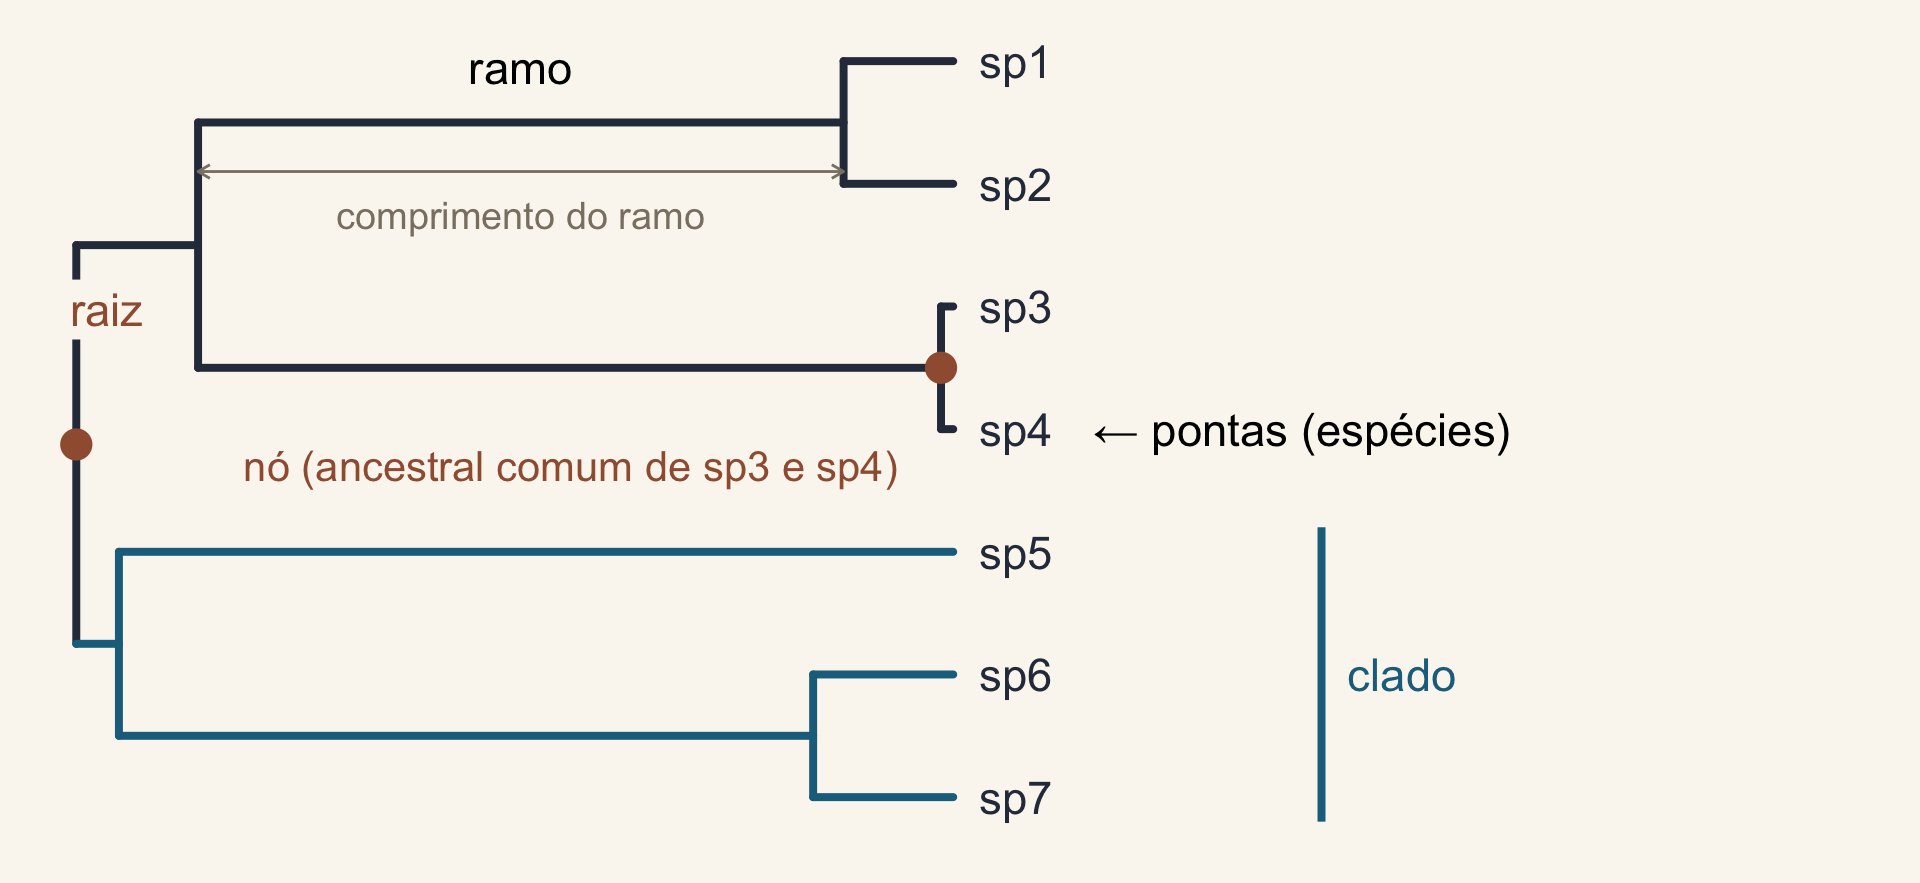
A árvore-guia anotada: a raiz à esquerda, um nó marcado como ancestral comum de sp3 e sp4, um ramo com seu comprimento, as pontas sp1 a sp7 e o clado sp5 a sp7 destacado em azul.

Enraizando a árvore

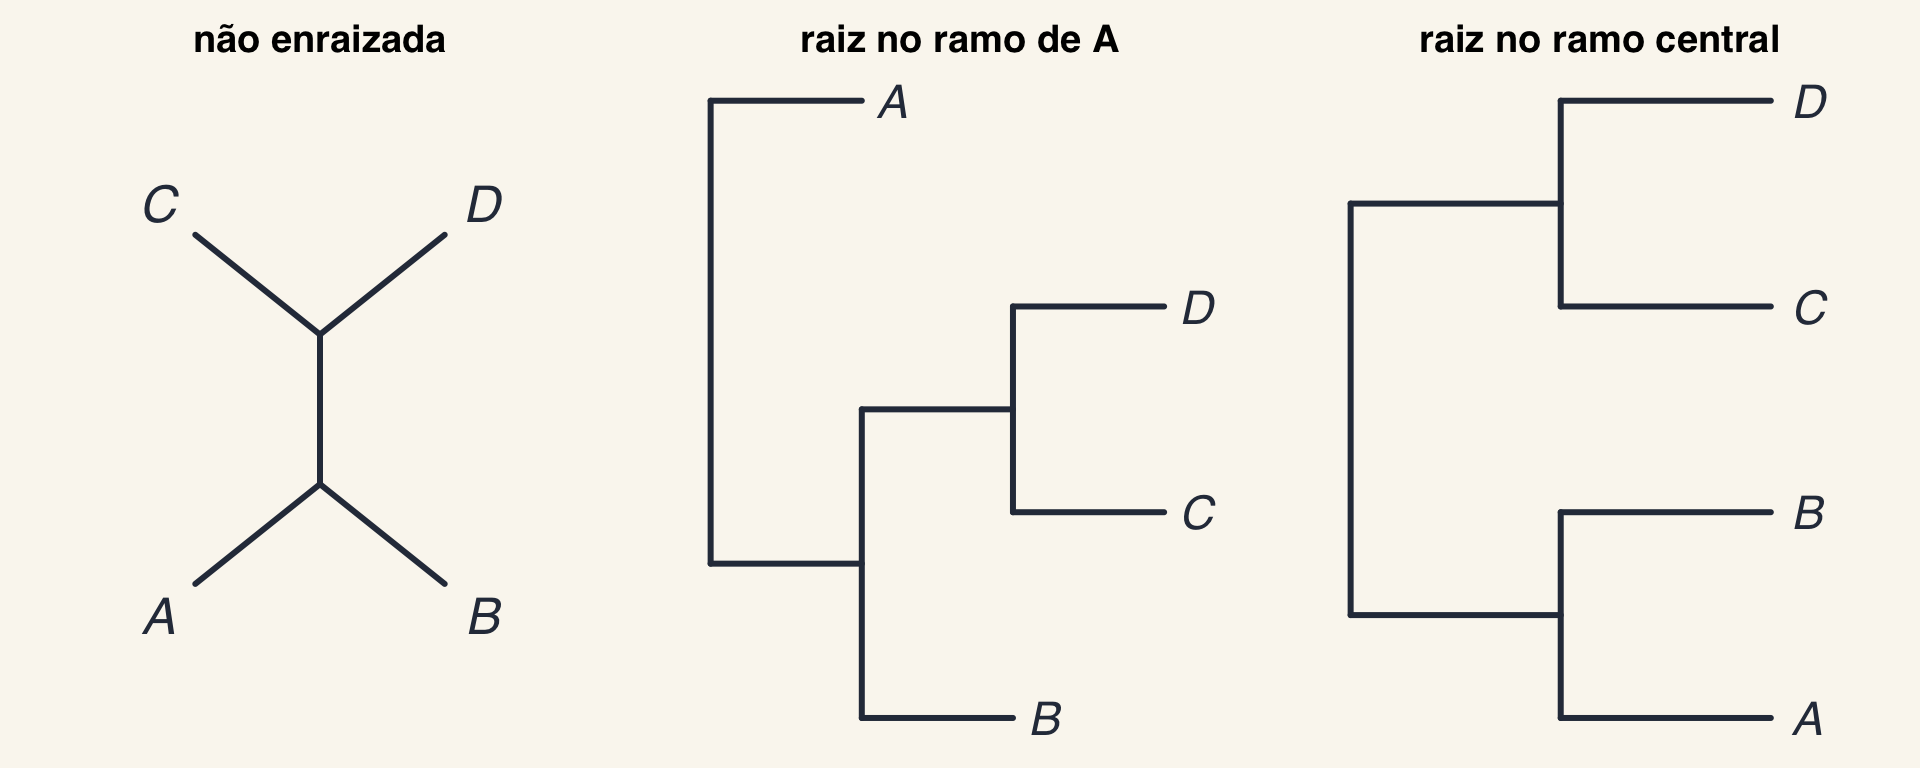
Três desenhos da mesma árvore de quatro espécies: não enraizada; enraizada no ramo de A, em que A fica igualmente aparentado a B, C e D; e enraizada no ramo central, em que A e B são irmãos, e C e D também.

Raiz no ramo de A: A não é mais aparentado a B do que a C ou D. Raiz no ramo central: A é irmão de B, e os dois são grupo-irmão de C e D. A raiz muda a leitura.

Politomias
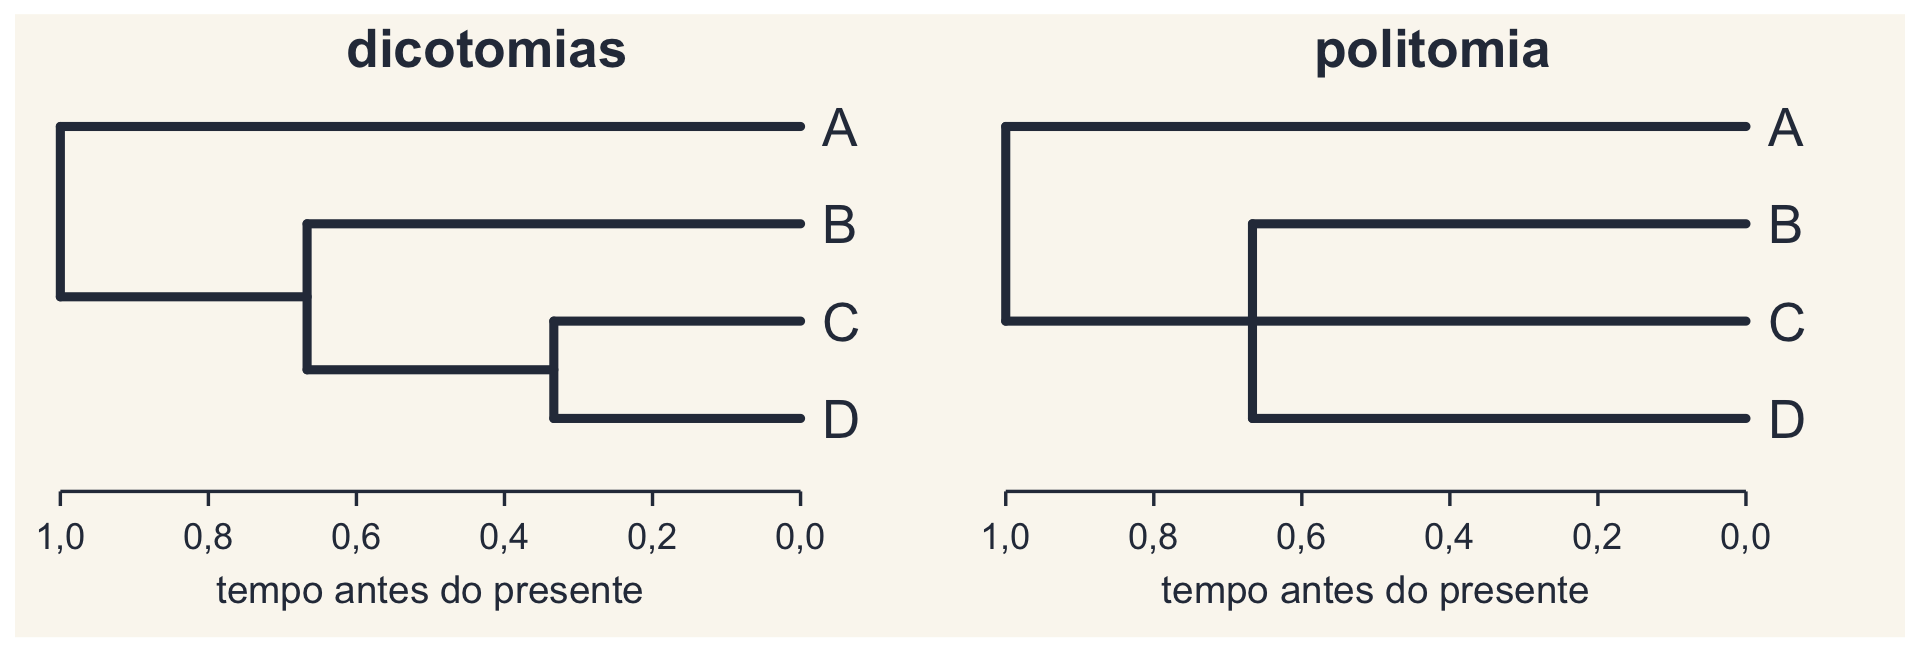
À esquerda, uma árvore só com dicotomias; à direita, uma árvore em que um nó dá origem a três descendentes, B, C e D.

  • Politomia: um nó (ancestral comum) com mais de dois descendentes
  • Soft: os dados não discriminam a ordem das divergências (divergência rápida)
  • Hard: a politomia é real, em geral uma “explosão” de espécies

Cladograma, filograma, cronograma
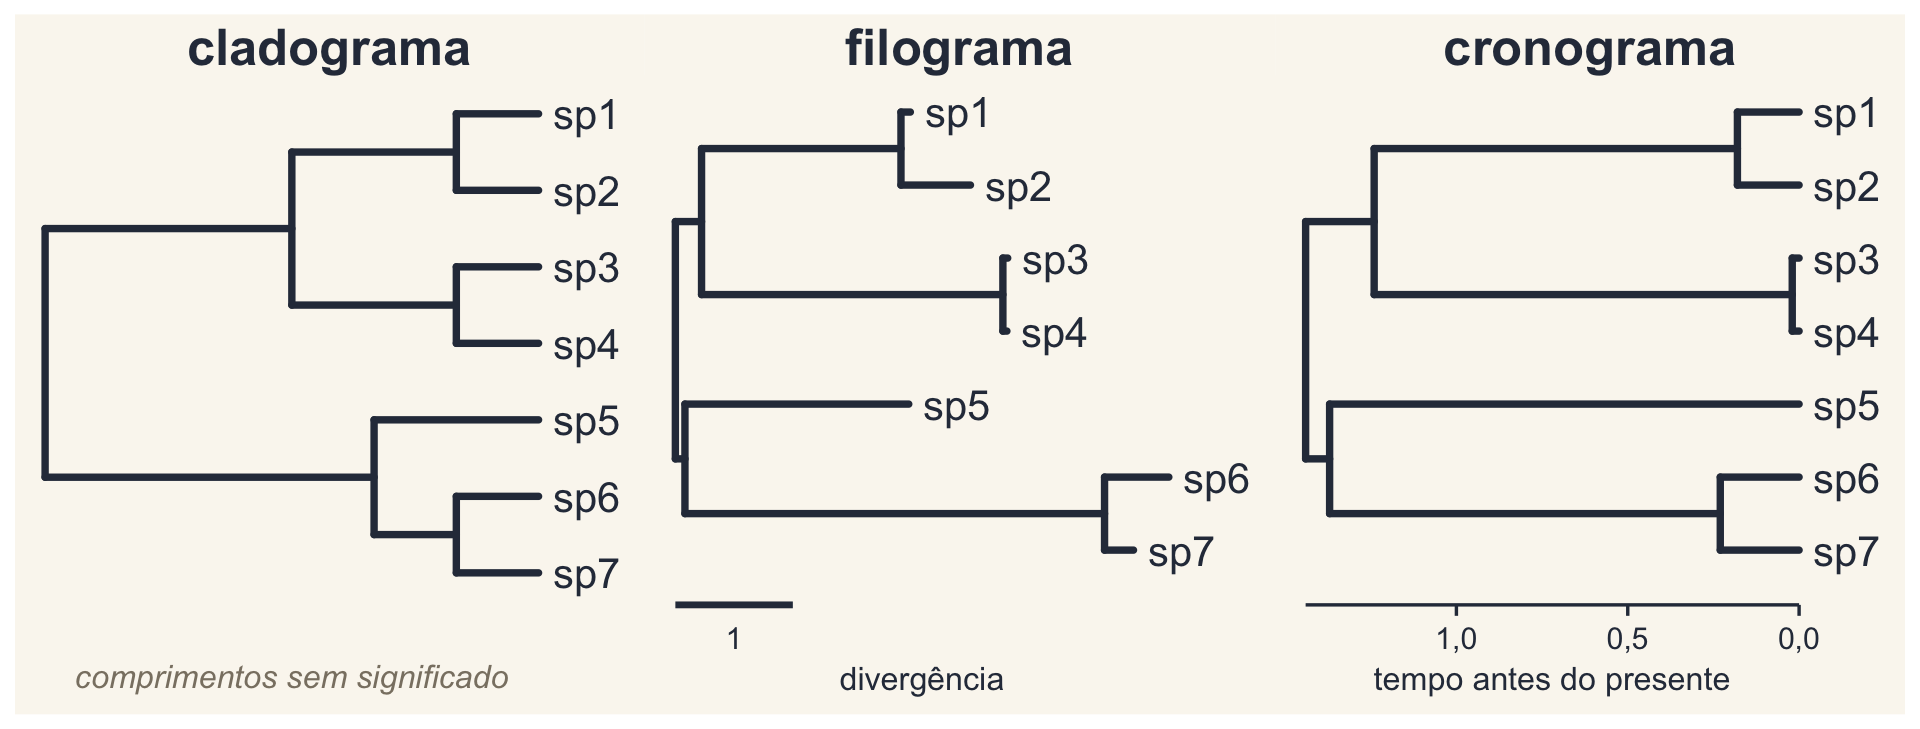
A árvore-guia desenhada de três formas: cladograma, com comprimentos sem significado; filograma, com ramos de comprimentos desiguais e pontas desalinhadas; e cronograma, com as pontas alinhadas no presente.

Cladograma: só as relações (e, opcionalmente, as sinapomorfias). Filograma: comprimentos = divergência. Cronograma: comprimentos = tempo (milhões de anos); árvore ultramétrica, obtida com um relógio molecular.

Suporte dos nós
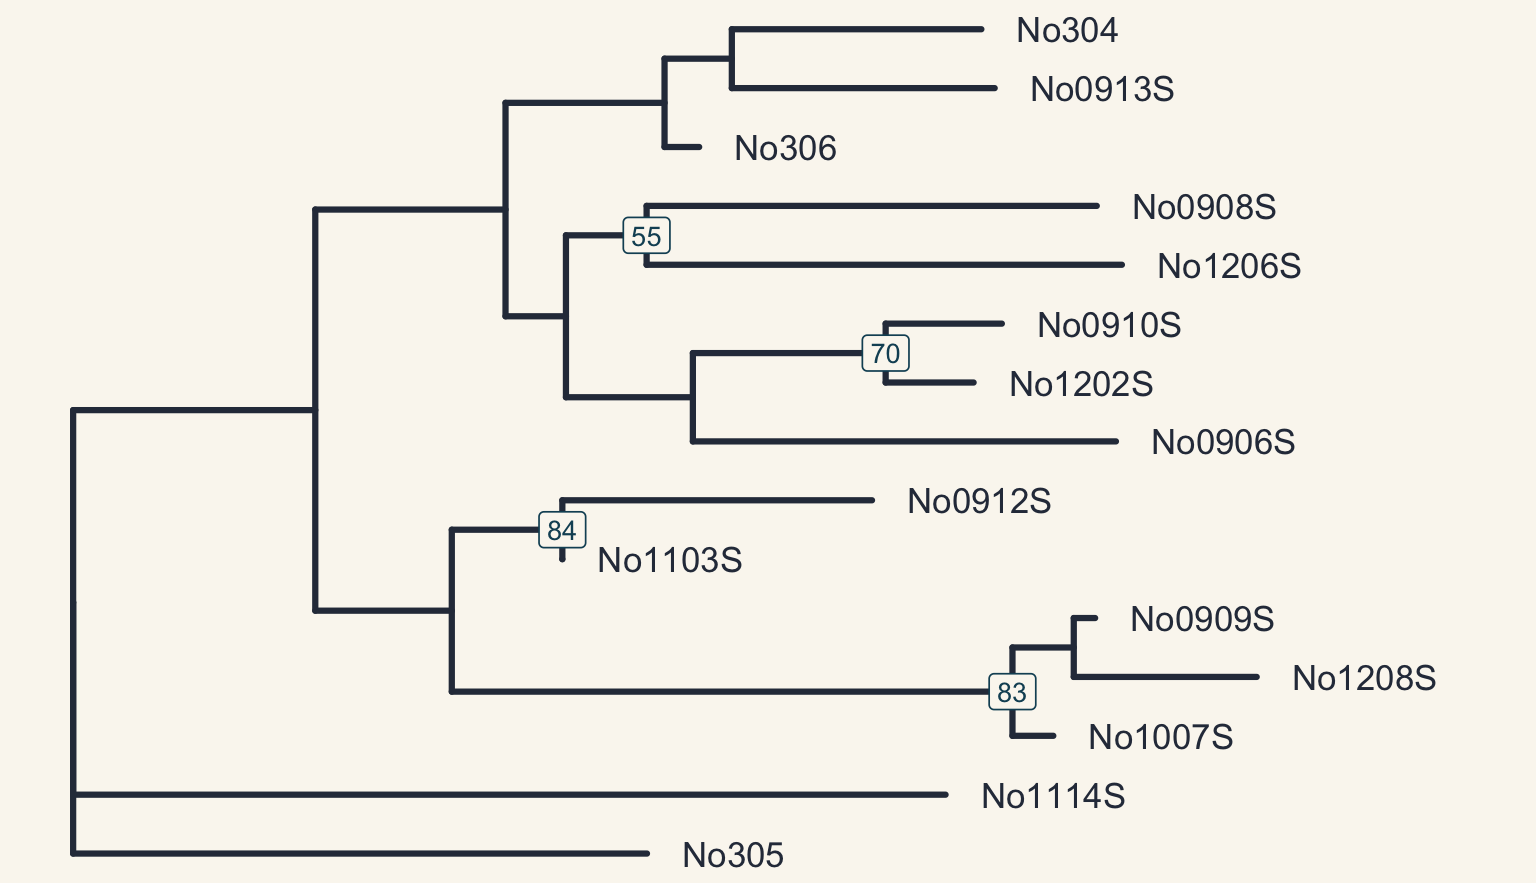
Árvore de vizinhos de 15 sequências de camundongos-do-mato com os valores de bootstrap de pelo menos 50 nos nós; vários nós têm suporte baixo.

Bootstrap (qualquer critério), Bremer (MP), probabilidade posterior (inferência bayesiana). Aqui: NJ com distância K80 nas 15 sequências de ape::woodmouse, 100 réplicas; nós com bootstrap ≥ 50.

2. Como escrever uma árvore

A árvore e os dados

O formato Newick

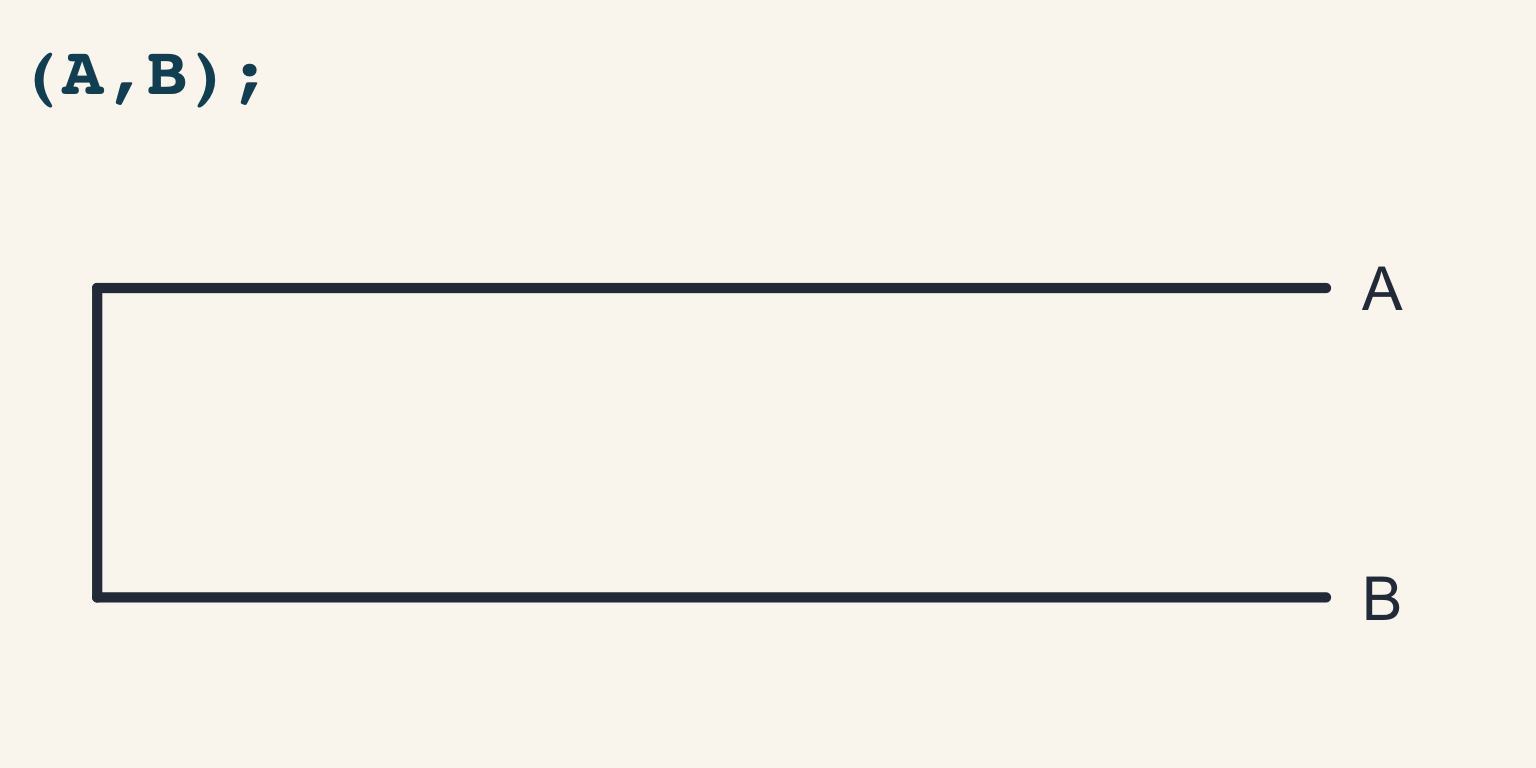
Uma árvore com duas pontas, A e B, sob o texto Newick (A,B);

Ideia de um slide de J. A. F. Diniz-Filho. Também chamado New Hampshire: especificação do PHYLIP.

Comprimentos de ramo
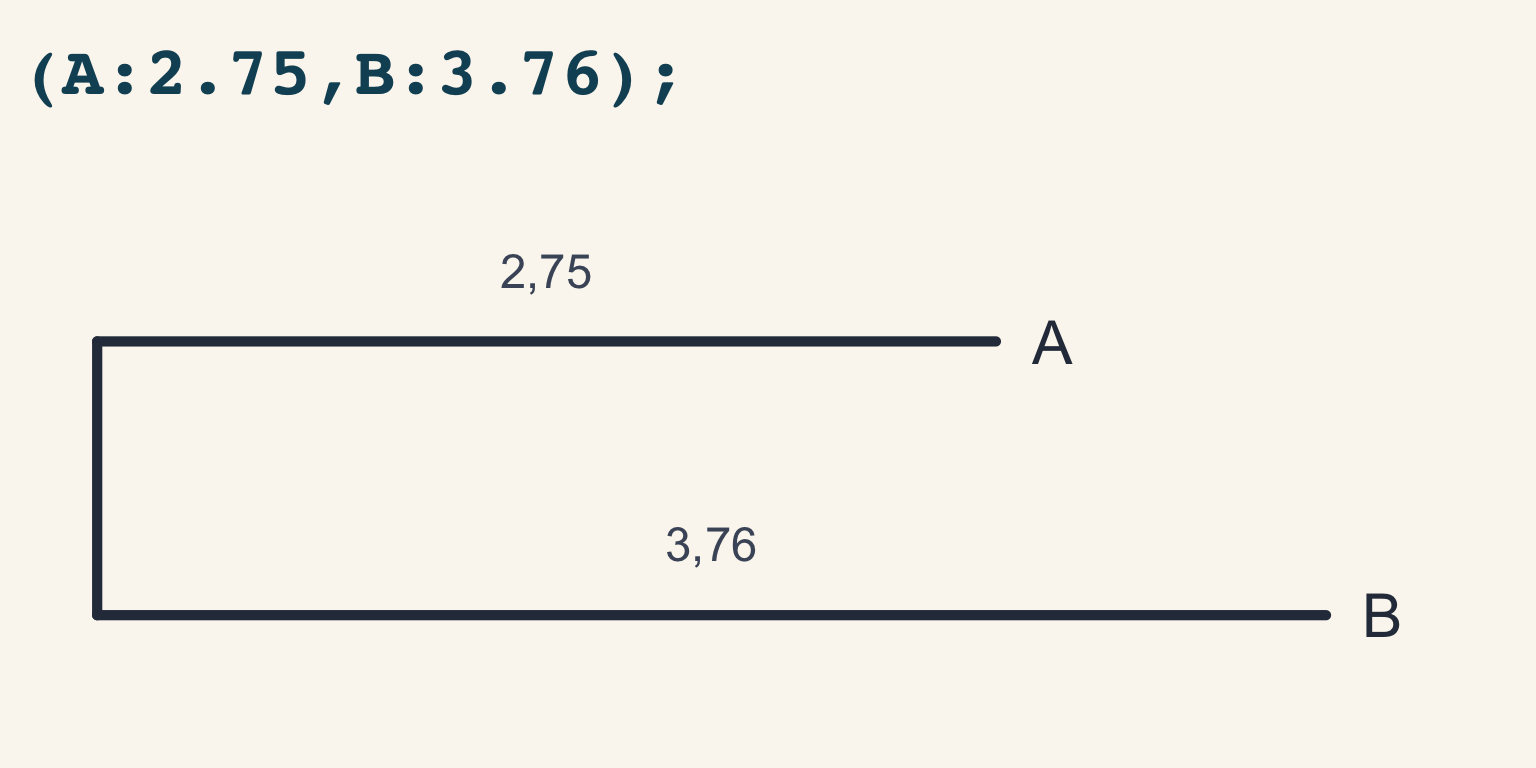
A mesma árvore com os comprimentos 2,75 e 3,76 escritos sobre os ramos, sob o texto (A:2.75,B:3.76);

Ideia de um slide de J. A. F. Diniz-Filho. O comprimento vem depois de dois-pontos; no arquivo, o decimal é ponto.

Um clado dentro de outro
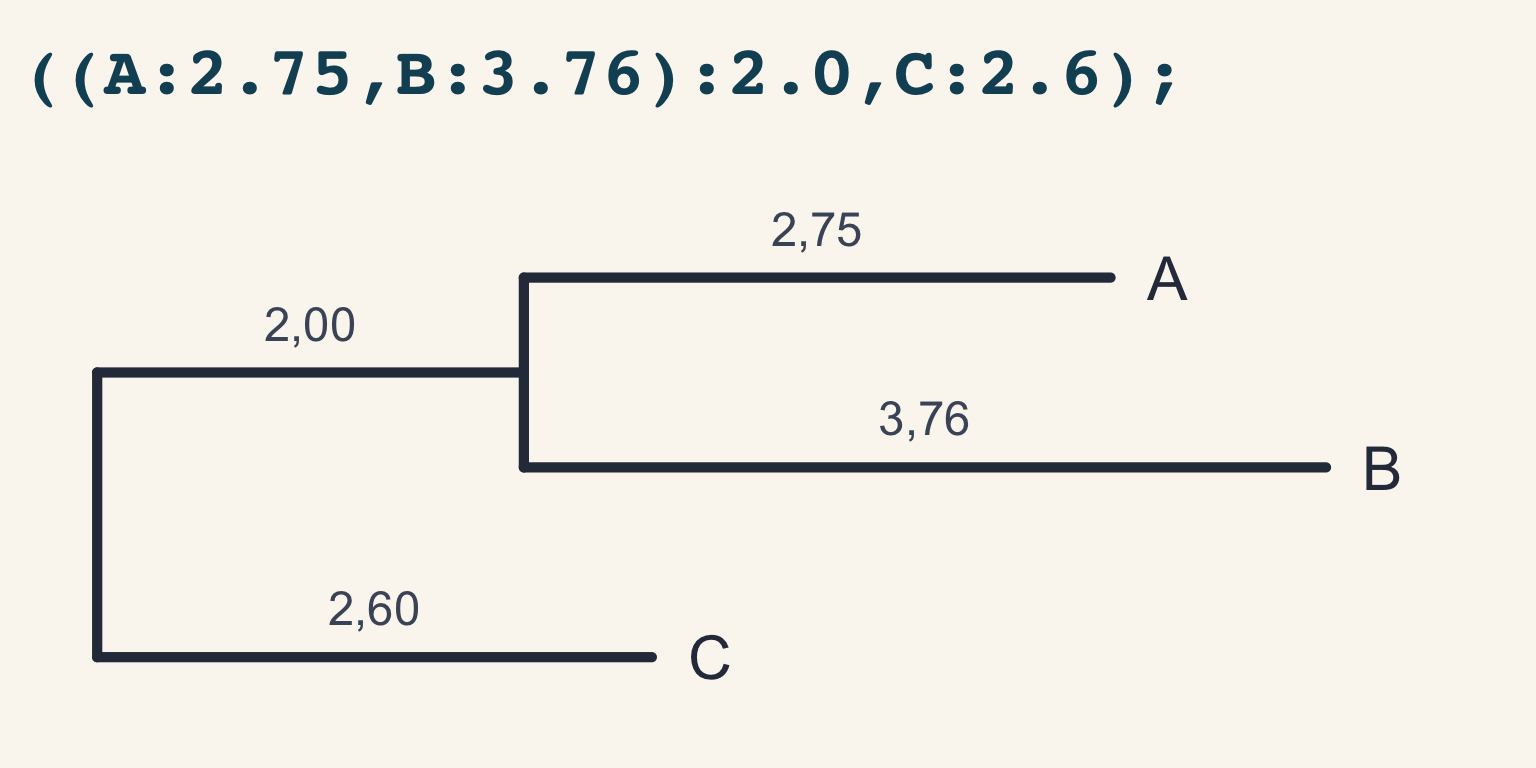
Árvore de três pontas em que A e B formam um clado com ramo de 2,0, irmão de C, com ramo de 2,6.

Ideia de um slide de J. A. F. Diniz-Filho.

Nomeando os nós
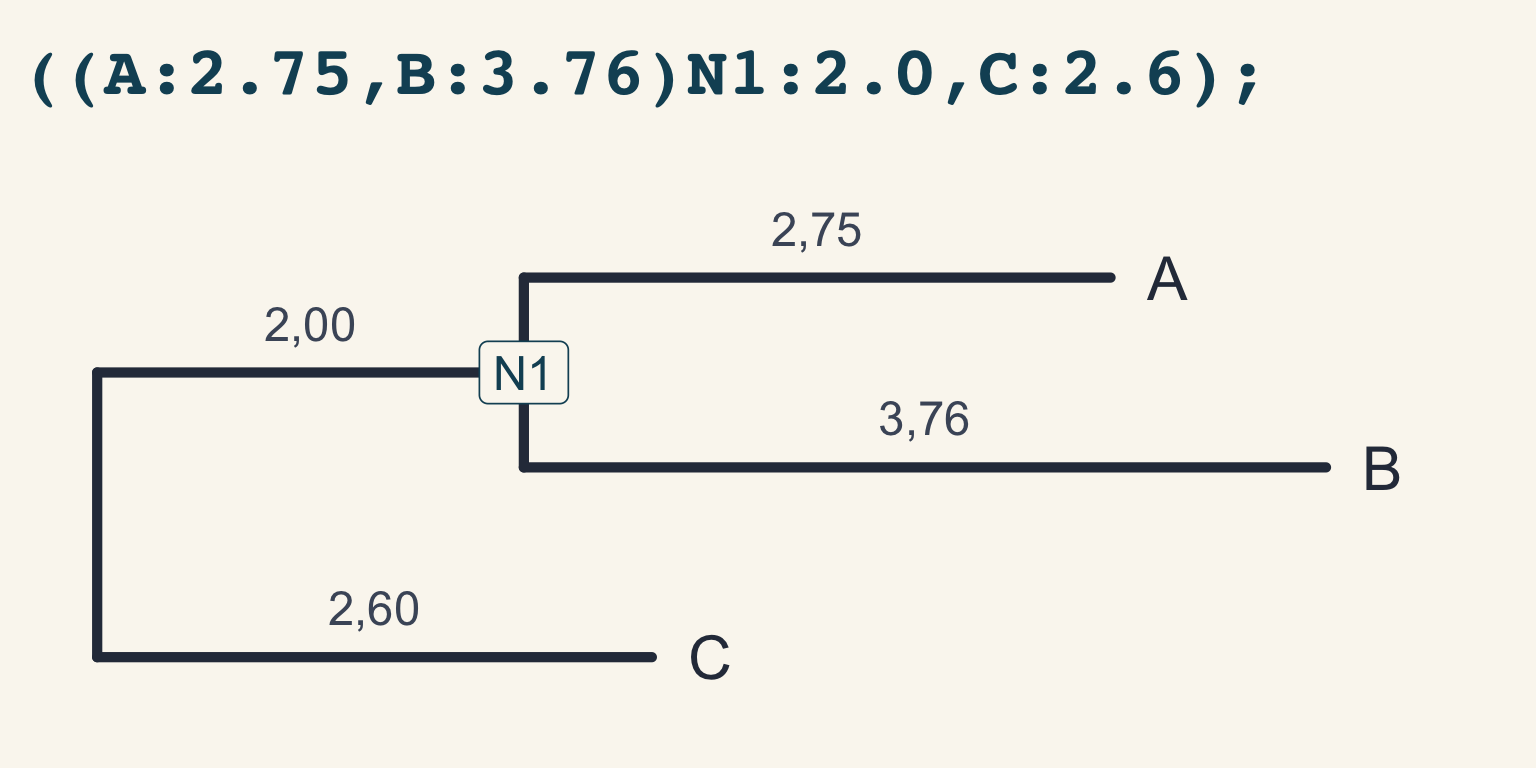
A mesma árvore com o nó de A e B chamado N1.

Ideia de um slide de J. A. F. Diniz-Filho.

Nomeando a raiz
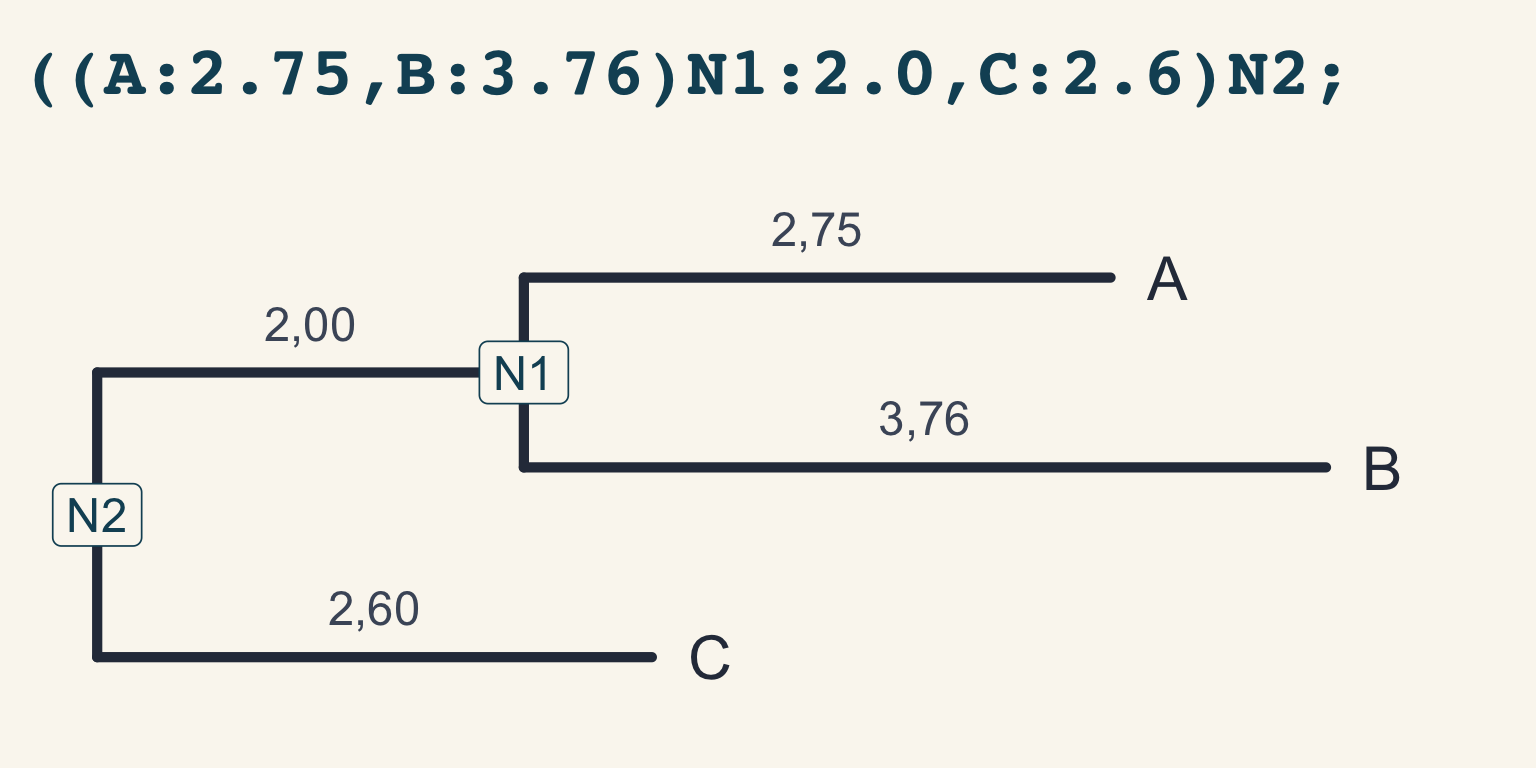
A mesma árvore com a raiz chamada N2.

arvore <- ape::read.tree(text = "((A:2.75,B:3.76)N1:2.0,C:2.6)N2;")

O formato Nexus

#NEXUS
begin taxa;
  dimensions ntax=3;
  taxlabels A B C;
end;

begin trees;
  tree t1 = ((A:2.75,B:3.76):2.0,C:2.6);
end;
  • Arquivo em blocos (taxa, characters/data, trees…)
  • Guarda dados e árvores juntos; lido por Mesquite, PAUP*, MrBayes, BEAST
  • No R: ape::read.nexus()

Maddison, Swofford & Maddison (1997), Syst. Biol. 46: 590–621.

E o NeXML?

Formato Guarda Uso
Newick só a árvore (e comprimentos) universal
Nexus árvores, dados, blocos de programas Mesquite, MrBayes, BEAST
NeXML árvores, dados e metadados validáveis (XML) arquivamento, troca entre bases

Vos et al. (2012), Syst. Biol. 61: 675–689. Compartilhar as árvores publicadas, com os dados: Stoltzfus et al. (2012), BMC Res. Notes 5: 574.

3. De onde vem a árvore

A árvore e os dados

Critérios de otimização

Com modelo explícito de evolução Sem modelo explícito
Baseados em caracteres máxima verossimilhança, inferência bayesiana máxima parcimônia
Baseados em distância distâncias corrigidas por modelo (NJ, Fitch-Margoliash) UPGMA

Adaptado de Van de Peer & Salemi (2009), The Phylogenetic Handbook; visão geral em Holder & Lewis (2003).

O caminho até a árvore

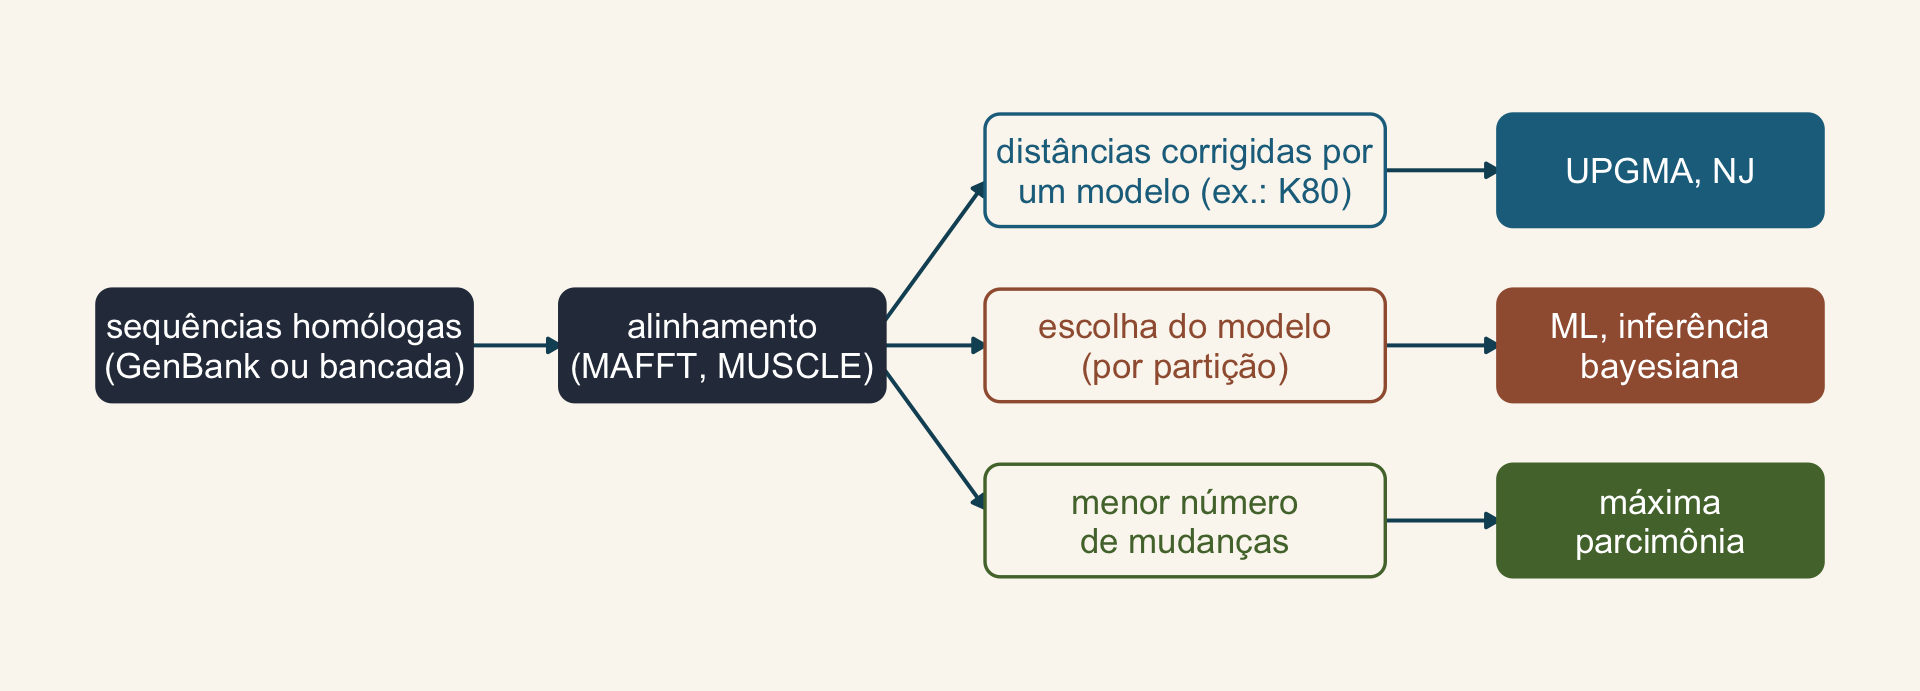
Fluxograma: sequências homólogas, alinhamento e então três caminhos: distâncias corrigidas por um modelo levando a UPGMA ou NJ; escolha do modelo por partição levando a ML ou inferência bayesiana; menor número de mudanças levando à máxima parcimônia.

Vantagens e problemas: distância e parcimônia

Método Ideia Vantagens Problemas
Distância (NJ, UPGMA) matriz de distâncias par a par → árvore rápido, bom para muitos dados fenético (não reconstrói a história por caracteres derivados compartilhados); perde a informação das sequências; uma só topologia; não julga qual árvore é melhor; lida mal com taxas heterogêneas; não estima estados ancestrais
Máxima parcimônia árvore com menos mudanças critério simples; morfologia e moléculas; rápida atração de ramos longos; ruim com divergência alta; comprimentos enviesados

Vantagens e problemas: verossimilhança e bayesiana

Método Ideia Vantagens Problemas
Máxima verossimilhança topologia e ramos que maximizam a probabilidade dos dados, dado um modelo critério estatístico; menos atração de ramos longos árvore errada se o modelo for errado; lenta
Inferência bayesiana distribuição posterior de árvores (MCMC, burn-in, priors) dá a incerteza (probabilidade posterior) depende dos priors e da convergência do MCMC

Um exemplo real

data(woodmouse, package = "ape")                # 15 sequências
d  <- ape::dist.dna(woodmouse, model = "K80")   # distância corrigida
nj <- ape::nj(d)                                # neighbor-joining
bs <- ape::boot.phylo(nj, woodmouse, \(x) ape::nj(ape::dist.dna(x, model = "K80")), B = 100)

Foi assim que saiu a árvore com o bootstrap do bloco 1. Na prática, use programas feitos para isso (próximo slide); o importante é saber ler a árvore e a sua incerteza.

Programas de inferência

Programa Critério Onde
PAUP* MP, ML, distância paup.phylosolutions.com
MEGA distância, MP, ML megasoftware.net · Kumar et al. (2018)
IQ-TREE 2 ML, seleção de modelo iqtree.github.io · Minh et al. (2020)
RAxML-NG ML em árvores grandes GitHub · Kozlov et al. (2019)
MrBayes bayesiana site · Ronquist et al. (2012)
BEAST 2 bayesiana, datação beast2.org · Bouckaert et al. (2019)
RevBayes bayesiana, modelos gráficos site · Höhna et al. (2016)
CIPRES, NGPhylogeny.fr servidores na nuvem phylo.org · ngphylogeny.fr

O que levar daqui

  • A árvore é uma hipótese, com incerteza na topologia e nos comprimentos de ramo
  • Ela depende dos dados, do alinhamento e do modelo
  • Para os MFC, o que mais importa: topologia, comprimentos (de preferência em tempo) e a incerteza (uma amostra de árvores, quando houver)

4. Como obter uma árvore

A árvore e os dados

Bases de árvores e de tempos de divergência

Recurso O que oferece No R / situação
TreeBASE árvores publicadas treebase (Boettiger & Temple Lang 2012); site fora do ar (out/2026)
TimeTree tempos de divergência Kumar et al. (2017)
Phylomatic árvore a partir de uma árvore de referência Webb, Ackerly & Kembel (2008)
Open Tree of Life árvore sintética de toda a vida rotl (Michonneau, Brown & Winter 2016); Hinchliff et al. (2015)
DateLife datar uma árvore com cronogramas publicados pacote datelife; site fora do ar (out/2026)
Congruificação datar uma árvore-alvo com uma de referência geiger::congruify.phylo (Eastman, Harmon & Tank 2013)

Por que tão poucas árvores publicadas ficam disponíveis: Stoltzfus et al. (2012) e The failure of phylogeny databases (R. Page, iPhylo). Vamos usar várias destas na prática.

Megafilogenias: supertree

Relações para muitas espécies, para estudos ecológicos ou comparativos em larga escala. Supertree: junta árvores menores, com alguma sobreposição de espécies.

  • Vantagens: combina fósseis e espécies atuais; só precisa das topologias; combina árvores de fontes de dados diferentes
  • Críticas: incongruências viram politomias; não distingue topologias com suporte alto e baixo; comprimentos de ramo sem significado (problema para os MFC); pouca resolução entre gêneros e espécies

Megafilogenias: supermatriz

Junta sequências já depositadas no GenBank, escolhendo marcadores que minimizem dados faltantes; alinha e estima a árvore com algoritmos para muitos terminais.

  • Limitações: GenBank sem padronização (nomes, sequências ruins: garbage in, garbage out); poucos genes em alguns grupos; alinhamento difícil; muito tempo filtrando sequências
  • Programas: RAxML/ExaML/ExaBayes (inferência), MAFFT, MUSCLE, ClustalW, T-Coffee (alinhamento), treePL (datação com muitos terminais)

Sequenciamento de nova geração

Sequencia DNA e RNA de forma muito mais rápida e barata que o Sanger, para muitos marcadores ao mesmo tempo: aumentou exponencialmente os dados das filogenias (filogenômica) e da filogeografia.

Mardis (2008), Annu. Rev. Genomics Hum. Genet. 9: 387–402. Roche 454 e SOLiD já foram descontinuadas.

Pipelines e árvores prontas

Recurso Para quê
PASTIS (Thomas, Hartmann & Jetz 2013) completar árvores com espécies sem dados genéticos, pela taxonomia
Aves (Jetz et al. 2012) · Squamata (Tonini et al. 2016) amostras de árvores completas · vertlife.org
Anfíbios (Jetz & Pyron 2018) · mamíferos (Upham, Esselstyn & Jetz 2019) novo: árvores completas atuais, também no vertlife
Plantas: V.PhyloMaker2 (Jin & Qian 2022) novo: megafilogenia a partir de uma lista de espécies
phruta (Román-Palacios 2023) novo: do GenBank à árvore datada, reprodutível no R · docs.ropensci.org/phruta
phyloGenerator (Pearse & Purvis 2013), PUmPER (Izquierdo-Carrasco et al. 2014), PHLAWD, SUPERSMART (Antonelli et al. 2017) gerar árvores do GenBank automaticamente; difíceis de instalar e pouco atualizados

Revisão: Roquet, Thuiller & Lavergne (2013), Ecography 36: 13–26.

Última opção: a árvore à mão

  • Montar a topologia sem comprimentos de ramo no Mesquite (ou no R)
  • Datar com o BLADJ, a partir de tempos de divergência de bases como o TimeTree

Os comprimentos interpolados são aproximações: trate os resultados com cautela.

5. Dados de atributos

A árvore e os dados

Bases de atributos

Base Grupo Link
TetrapodTraits (Moura et al. 2024) tetrápodes (~33 mil espécies) novo · Zenodo
AmphiBIO (Oliveira et al. 2017) anfíbios novo
AVONET (Tobias et al. 2022) · EltonTraits (Wilman et al. 2014) aves (e mamíferos) novo
PanTHERIA (Jones et al. 2009) mamíferos novo
TRY (Kattge et al. 2020) plantas try-db.org
FishBase peixes fishbase.se
MorphoBank (O’Leary & Kaufman 2011) · TraitBank (EOL) morfologia; vários morphobank.org · eol.org/traitbank
Ecological Archives · Scientific Data · Biodiversity Data Journal vários ESA · Sci. Data · BDJ

O Ecological Data Wiki e o Arbor (Harmon et al. 2013), análises comparativas na nuvem: ambos fora do ar (out/2026). Hoje, o mais próximo é o próprio R com Quarto.

6. Desenho de estudos comparativos

A árvore e os dados

Problemas mais comuns

  • Falta completa de dados (filogenéticos e de atributos)
  • Descompasso (mismatch) entre as espécies com atributos e as espécies na árvore
  • Dados que existem, mas não estão acessíveis
  • Déficits de conhecimento: o Darwiniano e o Raunkiaeriano

Os déficits

  • Raunkiaeriano: falta de informação sobre os atributos das espécies
  • Darwiniano: falta de informação sobre as relações entre as espécies

Os dois dificultam o estudo da evolução dos atributos e impedem análises comparativas.

Hortal et al. (2015), Annu. Rev. Ecol. Evol. Syst. 46: 523–549.

Três ignorâncias

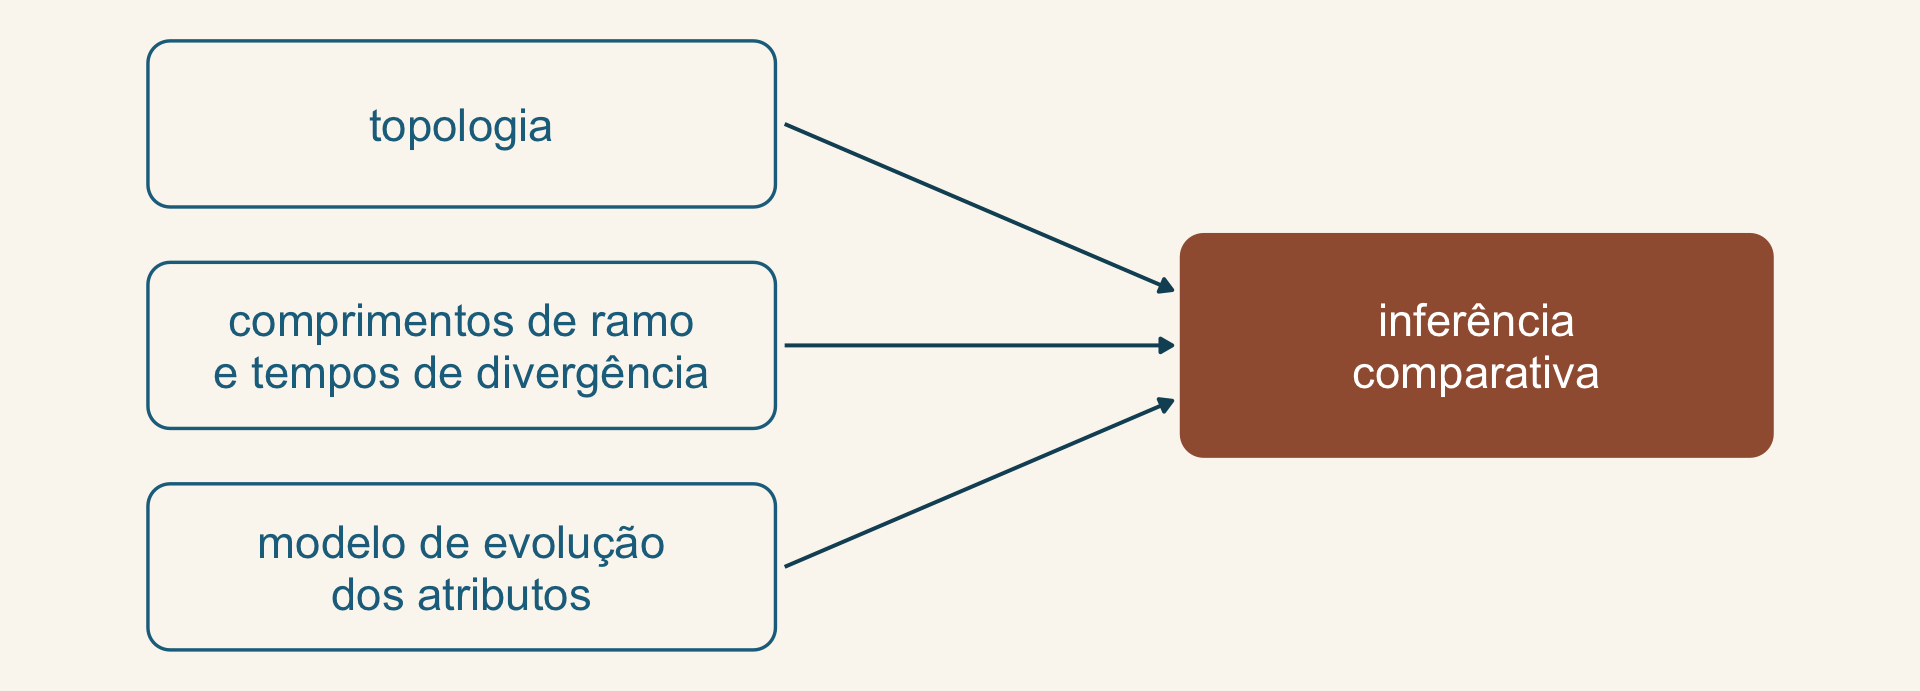
Diagrama: topologia, comprimentos de ramo e tempos de divergência, e modelo de evolução dos atributos, cada um com uma seta para inferência comparativa.

O déficit Darwiniano tem três componentes: não saber a topologia, os comprimentos de ramo ou o modelo de evolução dos atributos. Cada um propaga incerteza para a inferência.

Diniz-Filho et al. (2013), Trends Ecol. Evol. 28: 689–695.

Quando os dados não batem
Pintura Arrufos, de Belmiro de Almeida: uma mulher caída sobre um divã, chorando, enquanto um homem de terno fuma sentado numa poltrona, impassível. Legenda: metade das minhas espécies não está na árvore; calma, tem o phyndr.

Metade das minhas espécies não está na árvore! Calma: tem o phyndr

Belmiro de Almeida, Arrufos (1887), domínio público, via Wikimedia Commons.

phyndr

  • Maximiza a amostragem trocando espécies da árvore que não têm atributos por espécies “filogeneticamente equivalentes” que têm, sem mudar a estrutura da árvore
  • Usa a taxonomia (ou só os gêneros) ou uma árvore topológica
  • Alternativa à aleatorização ou à imputação de dados faltantes
  • Pacotes phyndr e taxonlookup

Pennell, FitzJohn & Cornwell (2016), Methods Ecol. Evol. 7: 751–758.

Imputar os dados faltantes

  • Usar a filogenia (e outros atributos) para prever os valores que faltam
  • Abordagens: autovetores filogenéticos (PVR, mapas de autovetores), modelos evolutivos (BM multivariado em Rphylopars), imputação por hipóteses ecológicas
  • Qual funciona melhor depende dos dados: compare antes de usar

PhyloTargeting

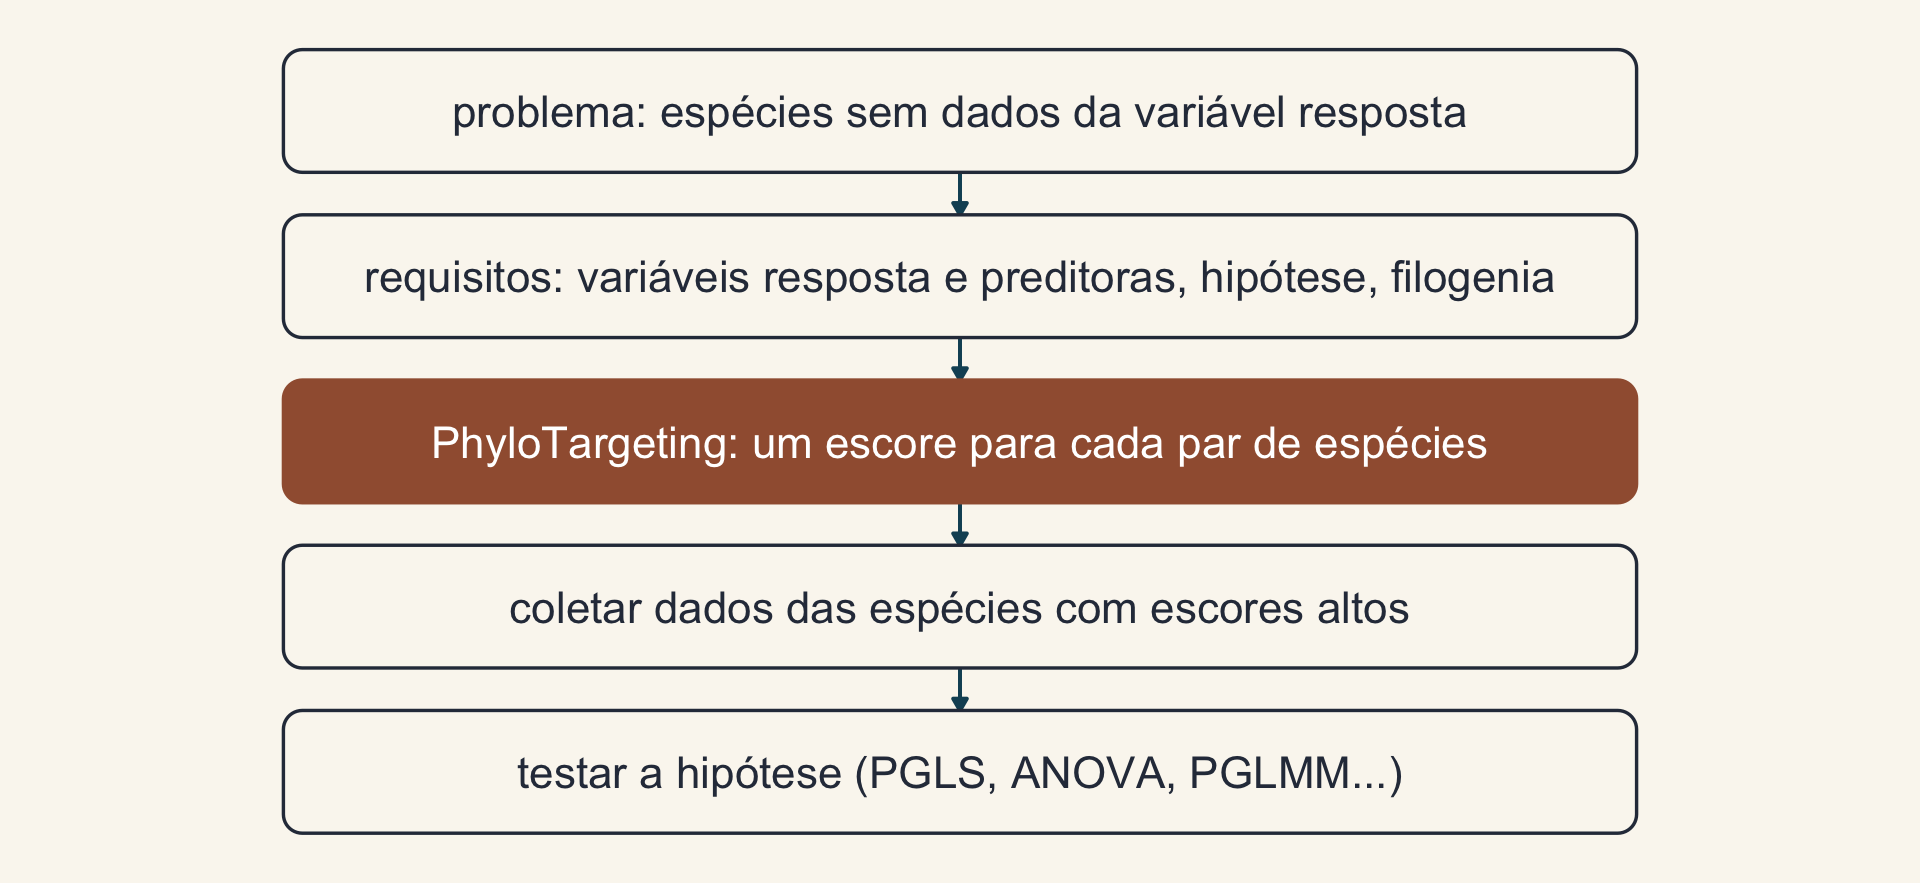
Fluxograma vertical: problema, espécies sem dados da variável resposta; requisitos, variáveis resposta e preditoras, hipótese e filogenia; PhyloTargeting, um escore para cada par de espécies; coletar dados das espécies com escores altos; testar a hipótese.

Como o PhyloTargeting funciona

  • Objetivo: escolher as espécies em que coletar a variável resposta, usando as preditoras das espécies já estudadas
  • Cada par de espécies recebe um escore que combina a filogenia e os valores das variáveis
  • São preferidas as espécies que mais diferem na resposta: amplia a variação e o poder do teste
  • Supõe relação linear; aceita variáveis discretas e contínuas e uma ou mais preditoras; serve a modelos lineares (PGLS, correlação, ANOVA, PGLMM)

7. A forma da árvore

A árvore e os dados

Balanceada × pente

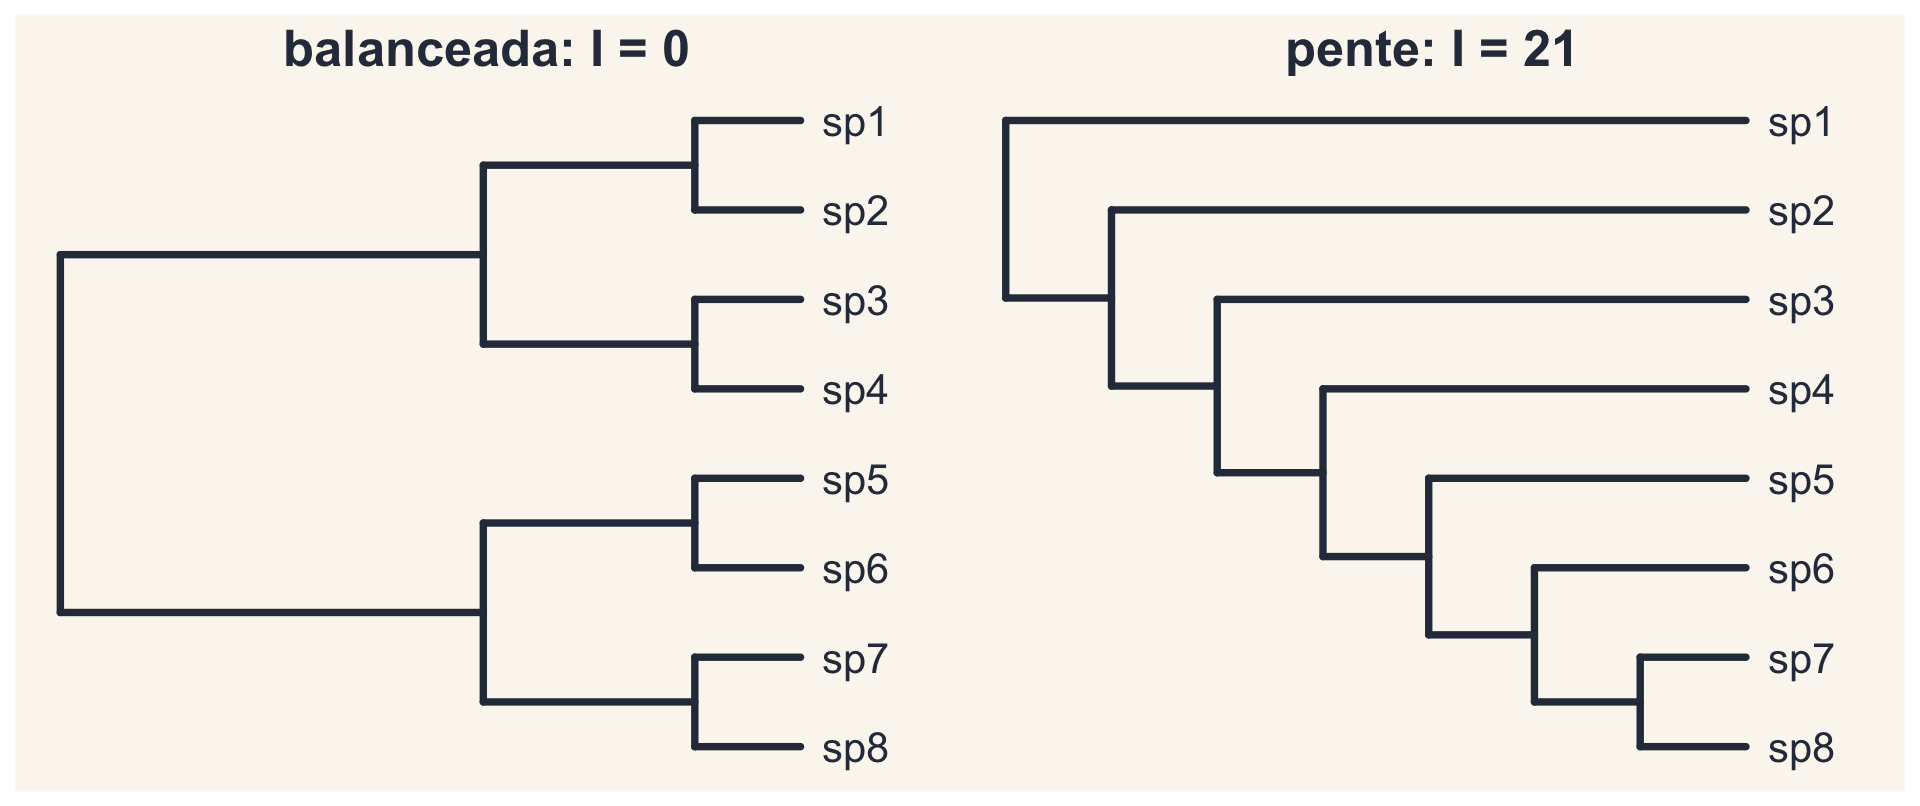
Duas árvores de oito espécies: uma totalmente balanceada, com índice de Colless zero, e uma totalmente desbalanceada, em pente, com índice 21.

Índice de Colless (I): soma, em cada nó, da diferença entre o número de pontas dos dois lados. 0 na balanceada, 21 no pente.

A simetria e o γ de Pybus

  • Estatísticas que descrevem a forma: as principais medem a simetria (Colless) e a distribuição dos nós no tempo (stemminess)
  • γ de Pybus & Harvey: γ < 0, nós concentrados perto da raiz; γ > 0, perto das pontas
  • Nas duas árvores: γ = 0,47 (balanceada) e -1,13 (pente)

Mooers & Heard (1997), Q. Rev. Biol. 72: 31–54; Pybus & Harvey (2000), Proc. R. Soc. B 267: 2267–2272; ape::gammaStat.

A forma muda a matriz C

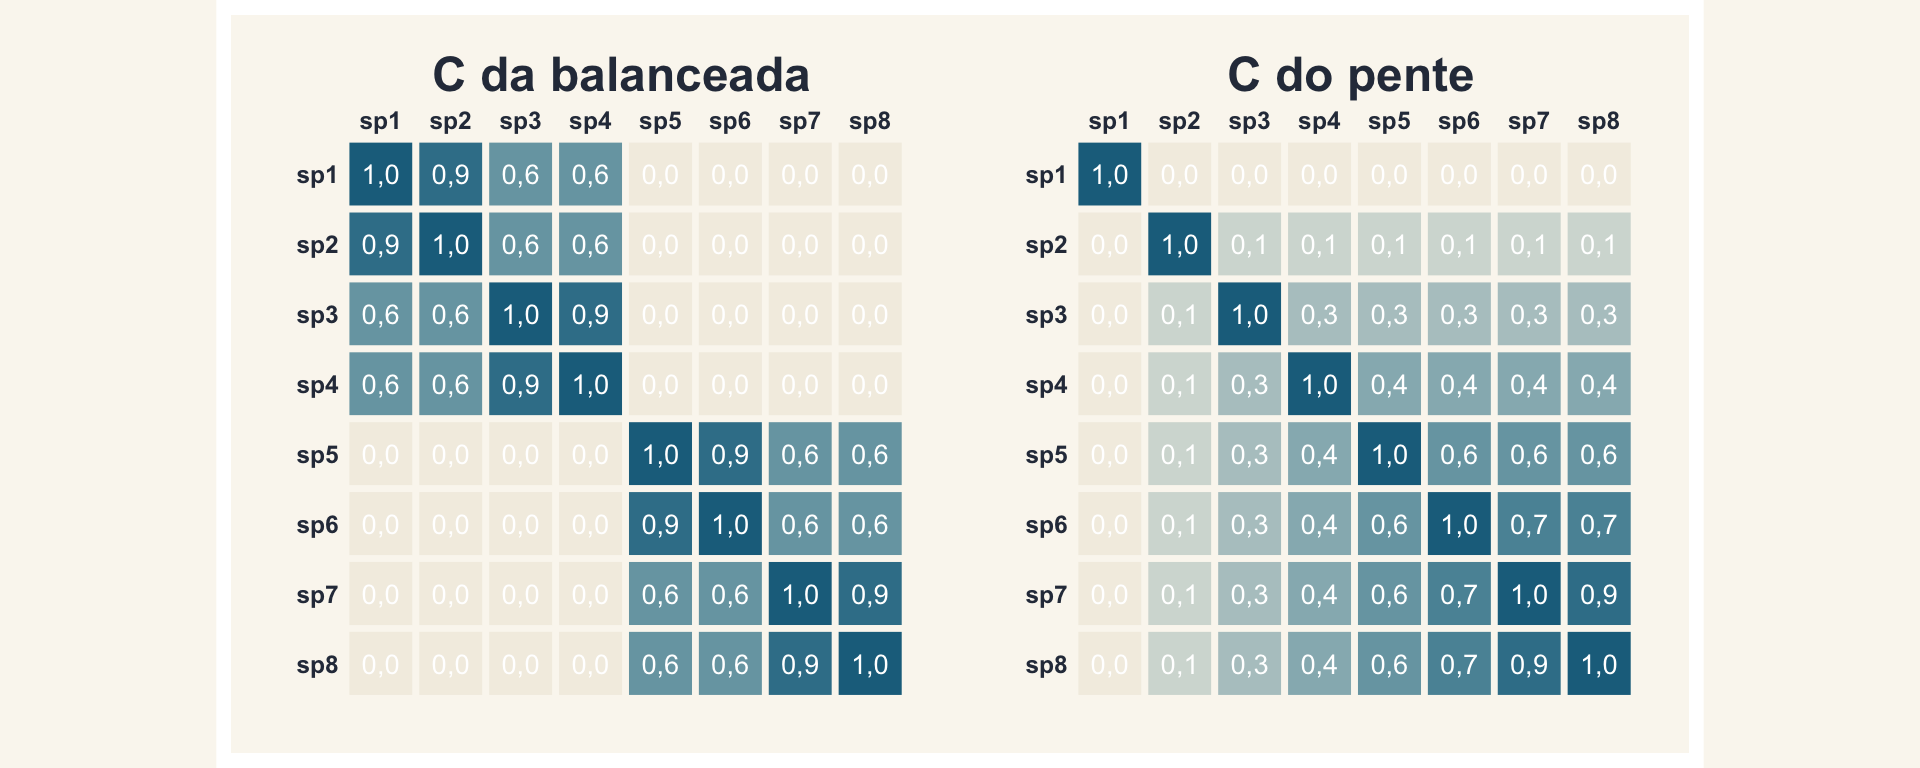
As matrizes de covariância filogenética das duas árvores, escalonadas de 0 a 1: na balanceada, dois blocos iguais de quatro espécies; no pente, valores que crescem em escada de sp1 para sp8.

A forma afeta a C (Aula 2) e, com ela, os testes e as estimativas de estados ancestrais.

Martins & Housworth (2002), Syst. Biol. 51: 873–880.

Para fechar

Onde estamos

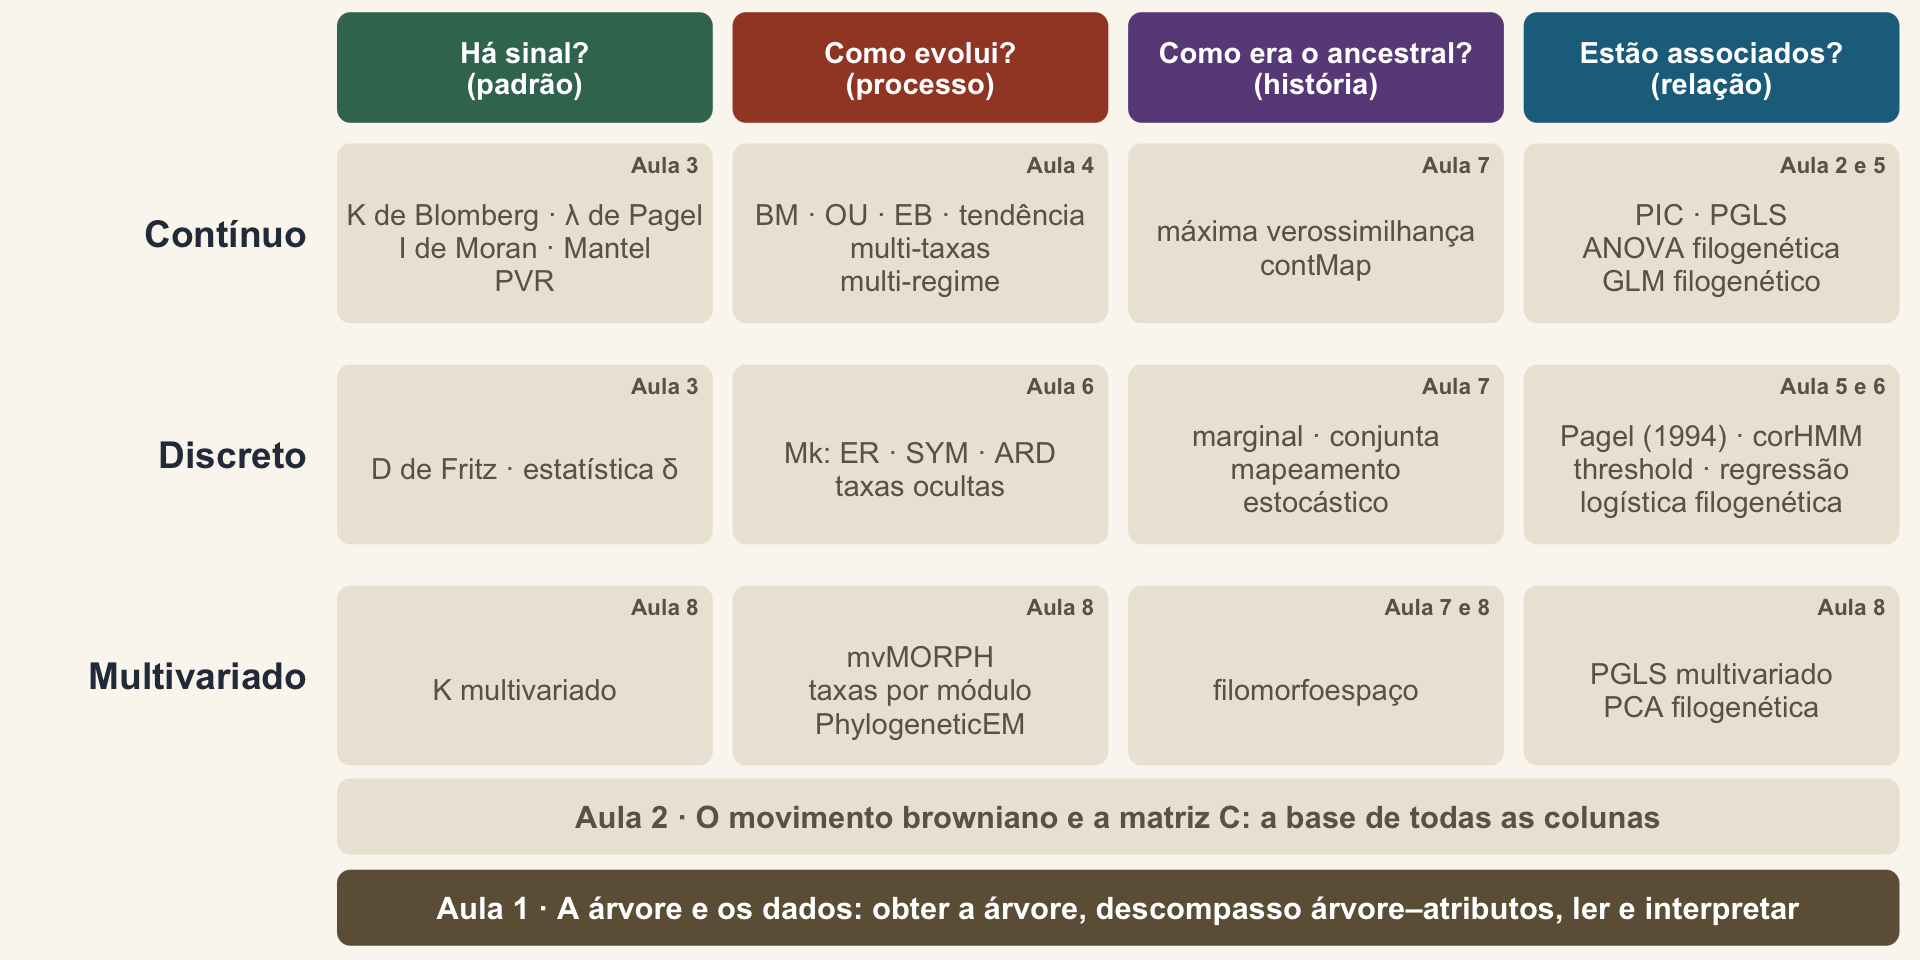
O mapa dos métodos de novo, com a faixa da Aula 1 destacada.

Leituras

Antes de usar qualquer método, leia o artigo que o propôs.

Agora é com vocês

Pintura O derrubador brasileiro, de Almeida Júnior: um homem de torso nu descansa sentado numa pedra na mata, com o machado ao lado. Legenda: árvore lida, dados conferidos; agora, mão na massa.

Árvore lida, dados conferidos Agora, mão na massa

Almeida Júnior, O derrubador brasileiro (1879), domínio público, via Wikimedia Commons. Prática: R, formatos de árvores, TimeTree, rotl, phyndr, PhyloTargeting e Rphylopars, e o desafio.