Curadoria de dados e boas práticas
Aula 02 · Introdução à Linguagem R
Diogo B. Provete
PPG em Ecologia e Conservação · UFMS
Roteiro
- Como nomear arquivos
- Como organizar uma planilha de dados
- Diretórios de trabalho e Projetos do RStudio
- Metadados e publicação dos dados
- Como escrever e organizar um script
Nomear arquivos
Melhores práticas para nomear arquivos
- Faça algo descritível
- Não seja genérico
- Faça algo que tenha um tamanho razoável
- Seja consistente
Adaptado de slides de Rebekah Cummings
Quem arquivou melhor?
MyData.xlsxGenérico demais — daqui a seis meses, quais dados são esses?
publiclibrarypartnershipsprojectevaluationdataworkshop22014CummingsHelenaMontana.xlsxDescritivo, mas ilegível.
PLPP_EvaluationData_Workshop2_2014.xlsxDescritivo e de tamanho razoável.
Adaptado de slides de Rebekah Cummings
Regras de nomenclatura
- Use apenas letras, números e sublinhados
- Sem caracteres especiais:
% @ # * ? ! - Sem espaços
- Minúsculas, ou intercale minúsculas e maiúsculas (
LikeThis) - Nem todo sistema é case sensitive: assuma que
isso,ISSOeiSsOsão a mesma coisa
Adaptado de slides de Rebekah Cummings
Datas e numeração
1. Comece com zeros para ganhar escala
001 002 009 019 9992. Se usar datas, use o formato AAAAMMDD
| Escrito assim | Veredito |
|---|---|
June2015 |
ruim |
06-18-2015 |
ruim |
20150618 |
ótimo |
2015-06-18 |
também serve |
Adaptado de slides de Rebekah Cummings · o formato de data é a norma ISO 8601
Quem arquivou melhor?
July 24 2014_SoilSamples%_v6Espaços, caractere especial, versão manual.
SoilSamples_FINAL“FINAL” nunca é final.
20140724_NSF_SoilSamples_CummingsData ordenável, projeto, conteúdo, responsável.
Adaptado de slides de Rebekah Cummings
Curadoria de dados
De onde vem esse roteiro
Gotelli, N.J. & Ellison, A.M. Princípios de Estatística em Ecologia. Porto Alegre: Artmed. Capítulo 8 — Gerenciamento e curadoria de dados.
O fluxograma a seguir é uma adaptação da Figura 8.7 desse capítulo.
O ciclo, primeira metade
Repare que os metadados nascem junto com os dados, não no fim.
O ciclo, segunda metade
Adaptado de Gotelli & Ellison, Figura 8.7 — com uma atualização: onde o livro diz “mídia permanente (papel, CD-ROM)”, hoje se lê repositório público com DOI. Voltamos nesse ponto no fim da aula.
Primeiros passos
Passar as informações do caderno de campo, do relatório de equipamentos etc. para o computador.
Organização de planilhas
- Cada observação numa linha — unidade amostral, ou pseudorréplica
- Cada variável numa coluna
- Cada célula um único valor
Essas três regras têm nome: dados organizados (tidy data). É o formato que o tidyverse inteiro pressupõe — guarde o termo, ele volta na aula 04.
Wickham, H. (2014). Tidy Data. Journal of Statistical Software 59(10). doi:10.18637/jss.v059.i10
Primeiros passos
- Sempre mantenha cópias extras em fontes diferentes: outro computador, ou armazenamento em nuvem
- Dados faltantes? Use
NA(Not Available) - Evite espaços; use
_para separar palavras - Assim que terminar de planilhar, confira novamente e contraste com a fonte original (p. ex., o caderno de campo)
O que nunca fazer
- NUNCA faça gráficos junto com a planilha de dados
- Evite usar mais de uma aba do Excel (ou de qualquer programa de planilhas)
- Salve de preferência em
.txtou.csv— ou outro formato aberto. Evite.xls: quem for abrir precisa ter o Excel instalado
Nomes e pastas
Planilha de espécies.xls |
✗ |
20180108-Composicao_especies_cerradinho_UFMS.txt |
✓ |
- Separe os arquivos em pastas para cada projeto
- Se possível, comece a usar controle de versão logo no início do projeto (é o assunto da próxima aula)
Exercício — o que há de errado aqui?
Em dupla, abram a planilha e listem tudo o que está errado, usando os critérios desta aula. Quinze minutos.
Baixar: Planilha de dados FINAL v2 (1).xlsx
Comecem pelo nome do arquivo — vocês já sabem contar pelo menos três erros antes de abrir.
Dados fictícios, inventados para o exercício.
A referência canônica desta aula
Broman, K.W. & Woo, K.H. (2018). Data Organization in Spreadsheets. The American Statistician 72(1): 2–10. doi:10.1080/00031305.2017.1375989
Doze páginas, acesso aberto, e cobre praticamente tudo o que vimos até aqui. Tem site companheiro com os exemplos.
Diretórios de trabalho
O caminho absoluto quebra
E o roteiro suplementar do artigo do Bovo — dado real, publicado — abre assim:
Ou seja: não roda em lugar nenhum sem edição manual. Acontece com todo mundo.
Funciona na sua máquina, hoje.
Falha na máquina do orientador, na do revisor, no computador do laboratório, e na sua daqui a dois anos quando você reorganizar as pastas.
É o erro nº 1 em scripts compartilhados. E é o mais fácil de evitar.
O que um Projeto do RStudio resolve
Um arquivo .Rproj na raiz da pasta do projeto. Ao abrir o projeto:
- o diretório de trabalho já vem definido — nenhum
setwd()no script - cada projeto ganha sessão própria do R, com seu histórico e suas abas
- todo caminho passa a ser relativo à raiz do projeto
O script deixa de depender de onde a pasta está no computador.
Uma estrutura que funciona
intro-r/
├── intro-r.Rproj
├── README.md
├── dados/
│   ├── anuros_altitude.csv              <- somente leitura, nunca editar
│   ├── metadados_anuros_altitude.md     <- o que cada coluna significa
│   └── processados/                     <- gerados pelo script, descartáveis
├── scripts/
│   ├── aula-01.R
│   ├── aula-04.R
│   └── aula-06.R
├── figuras/
└── relatorio.qmd
Os números nos scripts dizem a ordem de execução. dados/brutos/ nunca é tocado à mão — tudo que muda, muda por script.
here::here()
Mesmo dentro de um Projeto, o diretório de trabalho muda quando você renderiza um Quarto que está numa subpasta.
here() sempre devolve a raiz do projeto, de onde quer que você chame. Funciona no script, no Quarto e na máquina de quem clonar o repositório.
Metadados
Metadados
Armazene num arquivo separado, na mesma pasta dos dados, os métodos que você usou para obtê-los.
- Data de coleta
- Coletor
- Modelo e marca do equipamento
- Unidades de medida de cada variável
O nosso, por exemplo
dados/metadados_anuros_altitude.md — um arquivo de texto, versionável:
## Fonte
Bovo, R.P.; Simon, M.N.; Provete, D.B.; ... (2023). Beyond Janzen's
Hypothesis... doi:10.1093/iob/obad009

## Variáveis
| Coluna        | Unidade        | O que é                          |
|---------------|----------------|----------------------------------|
| EWL_Ugcm2s1   | µg H2O/cm²·s   | taxa de perda de água evaporativa|
| CTmax         | °C             | limite térmico crítico superior  |
| Tbr           | °C             | DERIVADA: CTmax - CTmin          |
| BIO_5         | °C             | temp. máxima do mês mais quente  |
Markdown, não Word. Cabe no git, o diff é legível, e daqui a três anos ele ainda abre. A unidade que vocês tirarem do nome da coluna tem que aparecer aqui — senão não foi movida, foi perdida.
Coluna derivada é uma armadilha
Tbr e WT já vêm prontas no arquivo. Confira em vez de confiar:
[1] "Mean relative difference: 6.843256e-05"[1] TRUEBatem. A segunda difere na quinta casa — arredondamento de quem gravou o arquivo, não discordância. Use all.equal(), não ==: == compara bit a bit e diz FALSE por uma diferença na décima quinta casa decimal.
Um padrão para metadados ecológicos
EML — Ecological Metadata Language — é o padrão usado pela rede LTER e pelo repositório da EDI.
ezEML é um editor online em formulário que gera EML sem que você precise escrever XML:
- funciona como um assistente, passo a passo
- checa o documento quanto a correção e completude
- lê a tabela de dados e infere boa parte das características dela
- exporta o EML pronto, ou envia direto para o repositório da EDI
ezEML na prática
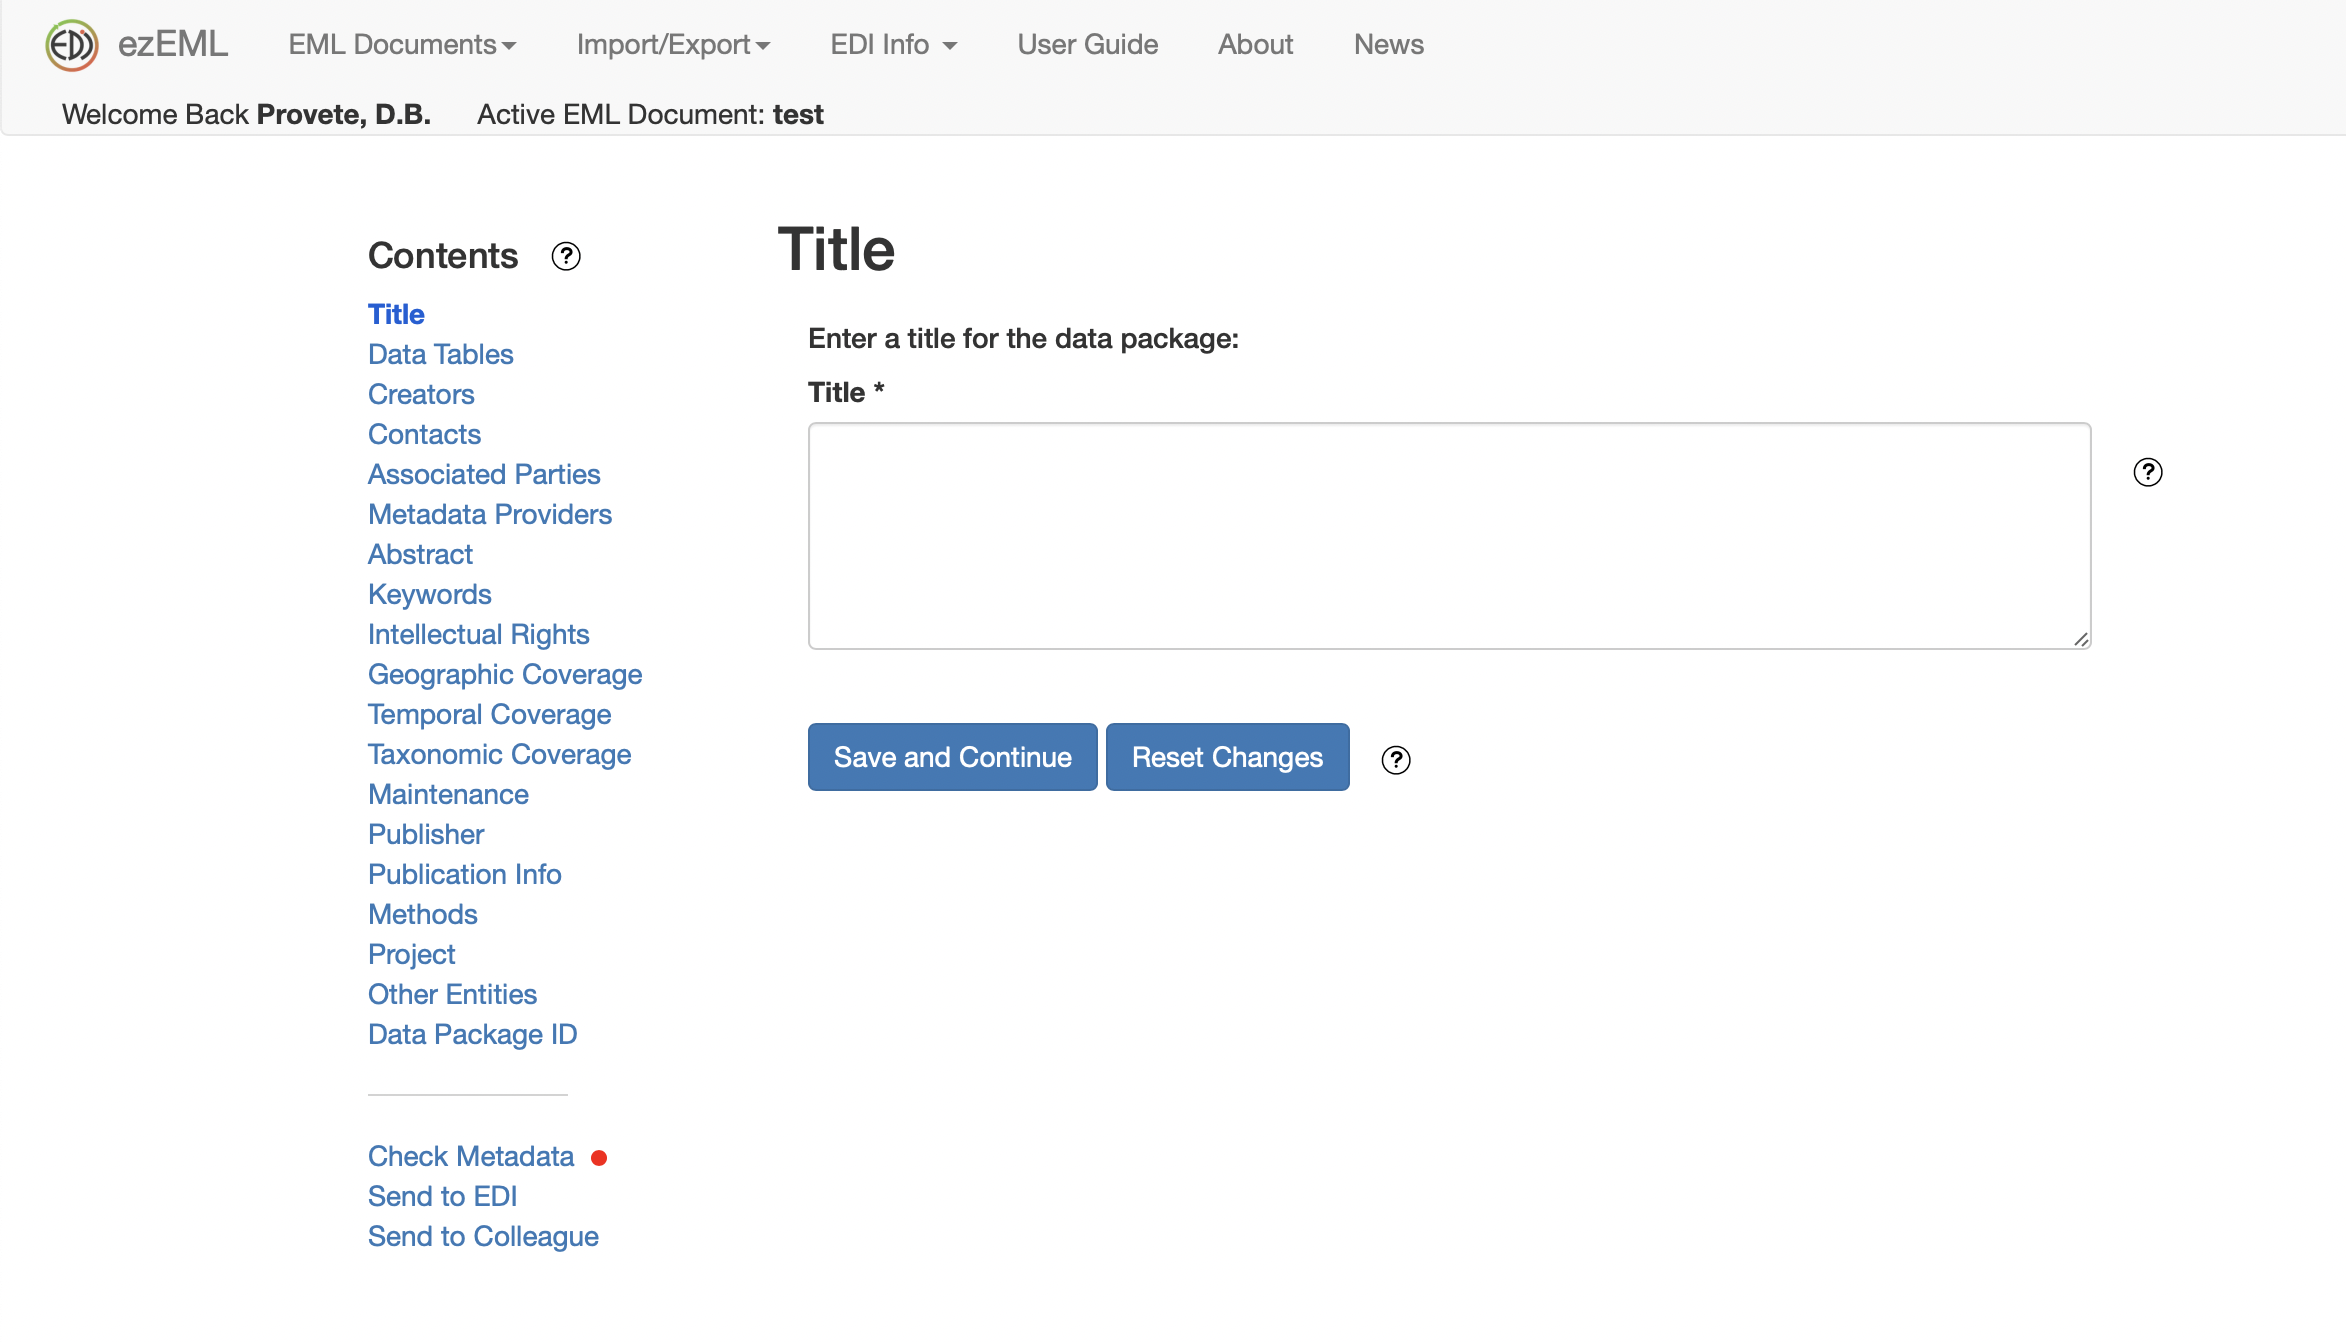
O formulário do ezEML: cada item do sumário à esquerda é uma seção do documento de metadados.
Publicando os dados num repositório
Vanderbilt, K.; Ide, J.; Gries, C.; Grossman-Clarke, S.; Hanson, P.; O’Brien, M.; Servilla, M.; Smith, C.; Waide, R.; Zollo-Venecek, K. (2022). Publishing Ecological Data in a Repository: An Easy Workflow for Everyone. The Bulletin of the Ecological Society of America. doi:10.1002/bes2.2018
Artigo de acesso aberto que descreve o caminho completo, do arquivo bruto ao DOI do conjunto de dados.
Análise exploratória
Análise exploratória de dados
Importe os dados e visualize os dados crus para verificar discrepâncias.
Plote usando o gráfico mais adequado ao tipo de dado:
- Scatter plot — duas variáveis contínuas
- Boxplot — um tratamento (preditora) e uma resposta contínua
- Um histograma nunca é demais
Primeiro, conte os ausentes
        Sex EWL_Ugcm2s1       CTmin       CTmax       BIO_5
107 11 1 35 0 - 107 sem sexo, de 225. Não é erro: nem sempre dá para sexar o animal
- 35 sem CTmax. Esses 35 somem de qualquer modelo que use CTmax
BIO_5não tem nenhum. Repare por quê no próximo slide
Uma variável de sítio, repetida por indivíduo
  Altitude_m BIO_5.n BIO_5.dp
1         35      39        0
2        550      18        0
3        820      36        0
4       1022      54        0
5       1500      23        0
6       1600      55        0
Desvio-padrão zero em toda altitude. BIO_5 não foi medida em cada animal — é o clima do sítio, copiado para as 39 linhas daquele sítio. São 6 valores independentes disfarçados de 225.
Por que isso importa
- O arquivo está certo: formato tidy quer uma linha por indivíduo
- O erro seria tratar as 225 linhas como 225 observações de clima
- Quem comparar clima entre sítios com n = 225 está inventando 219 graus de liberdade que não existem
Não dá para ver no summary() nem no str() — só contando. É o tipo de coisa que as Ten Simple Rules for Digital Data Storage tratam: Hart, E.M.; Barmby, P.; LeBauer, D.; Michonneau, F.; Mount, S.; Mulrooney, P.; Poisot, T.; Woo, K.H.; Zimmerman, N.B.; Hollister, J.W. (2016). PLOS Computational Biology 12(10): e1005097. doi:10.1371/journal.pcbi.1005097
Documente as alterações
Faça e documente qualquer alteração nos dados usando o script.
Evite mexer diretamente na planilha.
Se a alteração está no script, ela é reproduzível e reversível. Se está na planilha, ela é invisível.
Organizando o script
Guias de estilo
Qualquer um serve. O que não serve é não ter nenhum.
Melhores práticas em um script
- Comece com a data e o título do projeto
- Carregue os pacotes que vai usar, todos no começo
- Comente as linhas dizendo por que está fazendo aquilo
- Separe os elementos da linha de código com espaços
- Use
<-para atribuir, e não= - Quebre a linha se ela ficar muito longa
- Evite dar a objetos nomes que já existem
Melhores práticas em um script
- Escreva
TRUEeFALSE, nãoTeF - Separe o código em tópicos/partes
Para levar para o resto da semana
Nada disto se aprende ouvindo. A partir de amanhã, na prática:
- Todo código do curso roda dentro de um Projeto do RStudio
- Nenhum
setwd()em script nenhum — usehere() - Os arquivos que vocês criarem seguem as regras de nome da aula de hoje
- Se encontrarem na própria planilha algum erro da lista do exercício, me contem: é o melhor exemplo possível
E anotem, com uma frase cada, o que faz cada função nova de hoje — setwd(), here(), read.csv(). Esse caderninho vale mais que o slide.