library(dplyr)
library(ggplot2)
library(broom)
theme_set(theme_minimal(base_size = 12))Walkthrough — Modelos lineares
Aula 06 · Introdução à Linguagem R
Este documento é o aula-06.R executado. Ele parte do arquivo limpo produzido na aula 04 — se você ainda não rodou aquele script, rode antes.
Refazendo a limpeza da aula 04 (clique para ver)
anuros <- read.csv(here::here("dados", "anuros_altitude.csv")) %>%
  rename(id = ID, especie = Species, sexo = Sex,
         ewl = EWL_Ugcm2s1, massa = Bodymass_g,
         ctmin = CTmin, ctmax = CTmax,
         serra = Mountain_Range, altitude = Altitude_m) %>%
  select(id, especie, sexo, serra, altitude, massa, ewl, ctmin, ctmax,
         bio5 = BIO_5) %>%
  mutate(across(c(especie, serra, sexo), factor),
         amplitude = ctmax - ctmin,
         tol_aquec = ctmax - bio5,
         alt_fator = factor(altitude, levels = sort(unique(altitude))))
A pergunta
A tolerância ao aquecimento é a distância entre o limite térmico crítico superior do animal (CTmax) e a temperatura máxima do ambiente onde ele vive (BIO_5): quanto o ambiente ainda pode esquentar antes de encostar no limite fisiológico.
\[\text{tol\_aquec} = \text{CTmax} - \text{BIO}_5\]
Ela varia com a altitude?
ggplot(anuros, aes(altitude, tol_aquec)) +
  geom_point(alpha = .6) +
  labs(x = "Altitude (m)", y = "Tolerância ao aquecimento (°C)")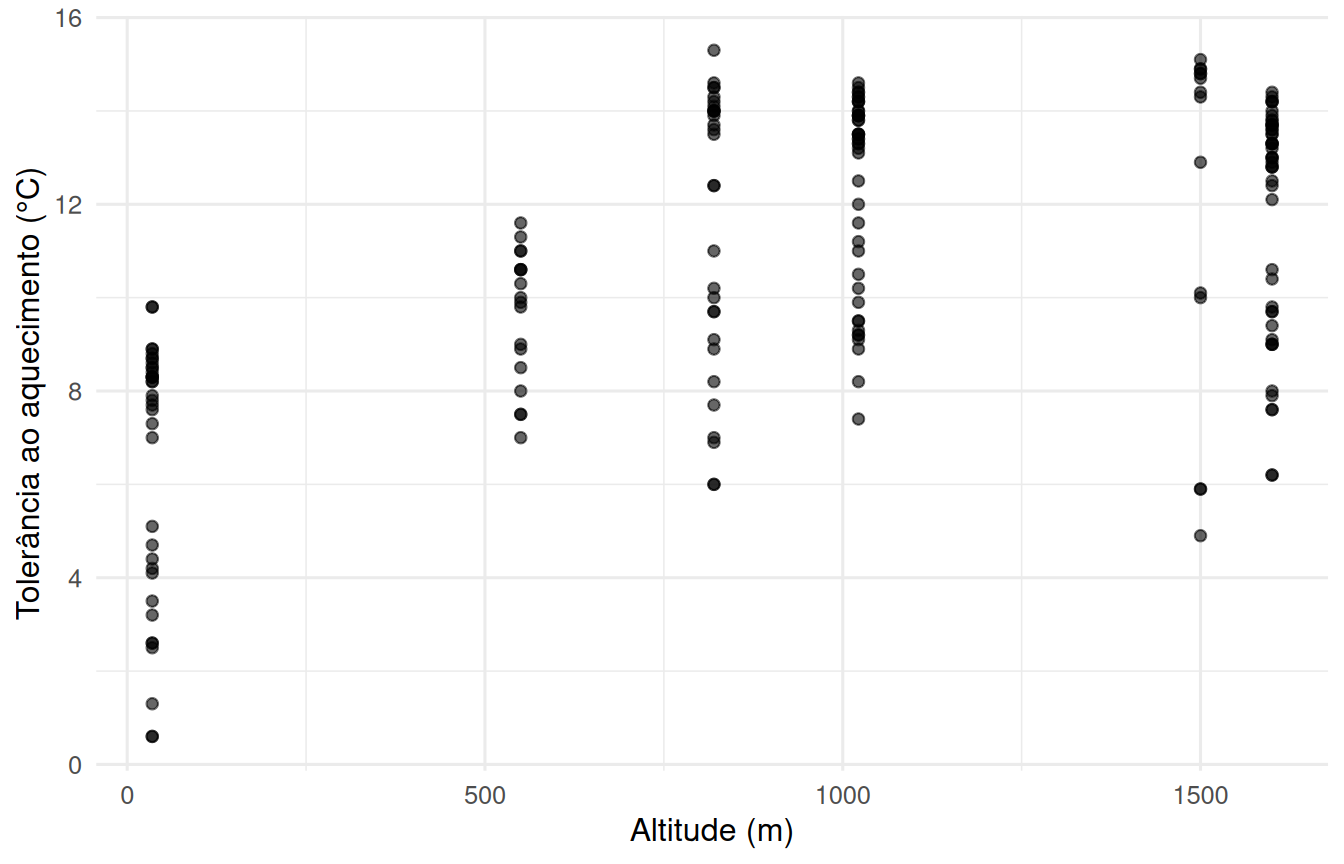
Antes de qualquer modelo, repare em duas coisas no gráfico: a tendência parece subir, e os pontos estão em seis colunas verticais. Não há altitude contínua nesta amostra; há seis sítios.
O modelo mais simples
m1 <- lm(tol_aquec ~ altitude, data = anuros)
summary(m1)
Call:
lm(formula = tol_aquec ~ altitude, data = anuros)

Residuals:
    Min      1Q  Median      3Q     Max
-7.6744 -1.7706  0.6016  2.1410  5.0072

Coefficients:
             Estimate Std. Error t value Pr(>|t|)
(Intercept) 7.5415236  0.4004935  18.831   <2e-16 ***
altitude    0.0033553  0.0003672   9.137   <2e-16 ***
---
Signif. codes:  0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1

Residual standard error: 2.803 on 188 degrees of freedom
  (35 observations deleted due to missingness)
Multiple R-squared:  0.3075,    Adjusted R-squared:  0.3038
F-statistic: 83.49 on 1 and 188 DF,  p-value: < 2.2e-16
Leia o summary de trás para frente:
- F-statistic / R² — o modelo explica alguma coisa? Aqui, cerca de 30 % da variação.
- Coefficients — direção e tamanho. O coeficiente de
altitudeé positivo: a tolerância aumenta com a altitude. - Intercept — a previsão em altitude = 0 m. Aqui quase faz sentido, já que o sítio mais baixo está a 35 m. Nem sempre é assim.
NotaPor que a tolerância sobe com a altitude?
Parece contraintuitivo até você lembrar da definição. Compare as duas metades da subtração ao longo do gradiente:
| altitude | serra | BIO_5 (°C) | CTmax médio (°C) |
|---|---|---|---|
| 35 | Serra do Mar | 30.4 | 36.84 |
| 550 | Serra da Mantiqueira | 28.5 | 38.12 |
| 820 | Serra do Mar | 25.3 | 36.88 |
| 1022 | Serra do Mar | 24.8 | 37.15 |
| 1500 | Serra do Mar | 23.8 | 35.77 |
| 1600 | Serra da Mantiqueira | 25.0 | 36.85 |
O CTmax dos animais quase não muda — fica entre 35,8 e 38,1 °C em todas as altitudes. A temperatura máxima do ambiente cai de 30,4 °C a 35 m para 23,8 °C a 1500 m. A diferença entre os dois, portanto, aumenta: quem vive no alto tem mais margem.
(Repare que o sítio de 1600 m tem BIO_5 de 25,0 °C, acima do de 1500 m. Ele fica na outra serra. Altitude não é temperatura.)
O corolário incômodo é o das terras baixas: é lá que a margem é menor.
Diagnóstico antes de interpretar
par(mfrow = c(2, 2))
plot(m1)
par(mfrow = c(1, 1))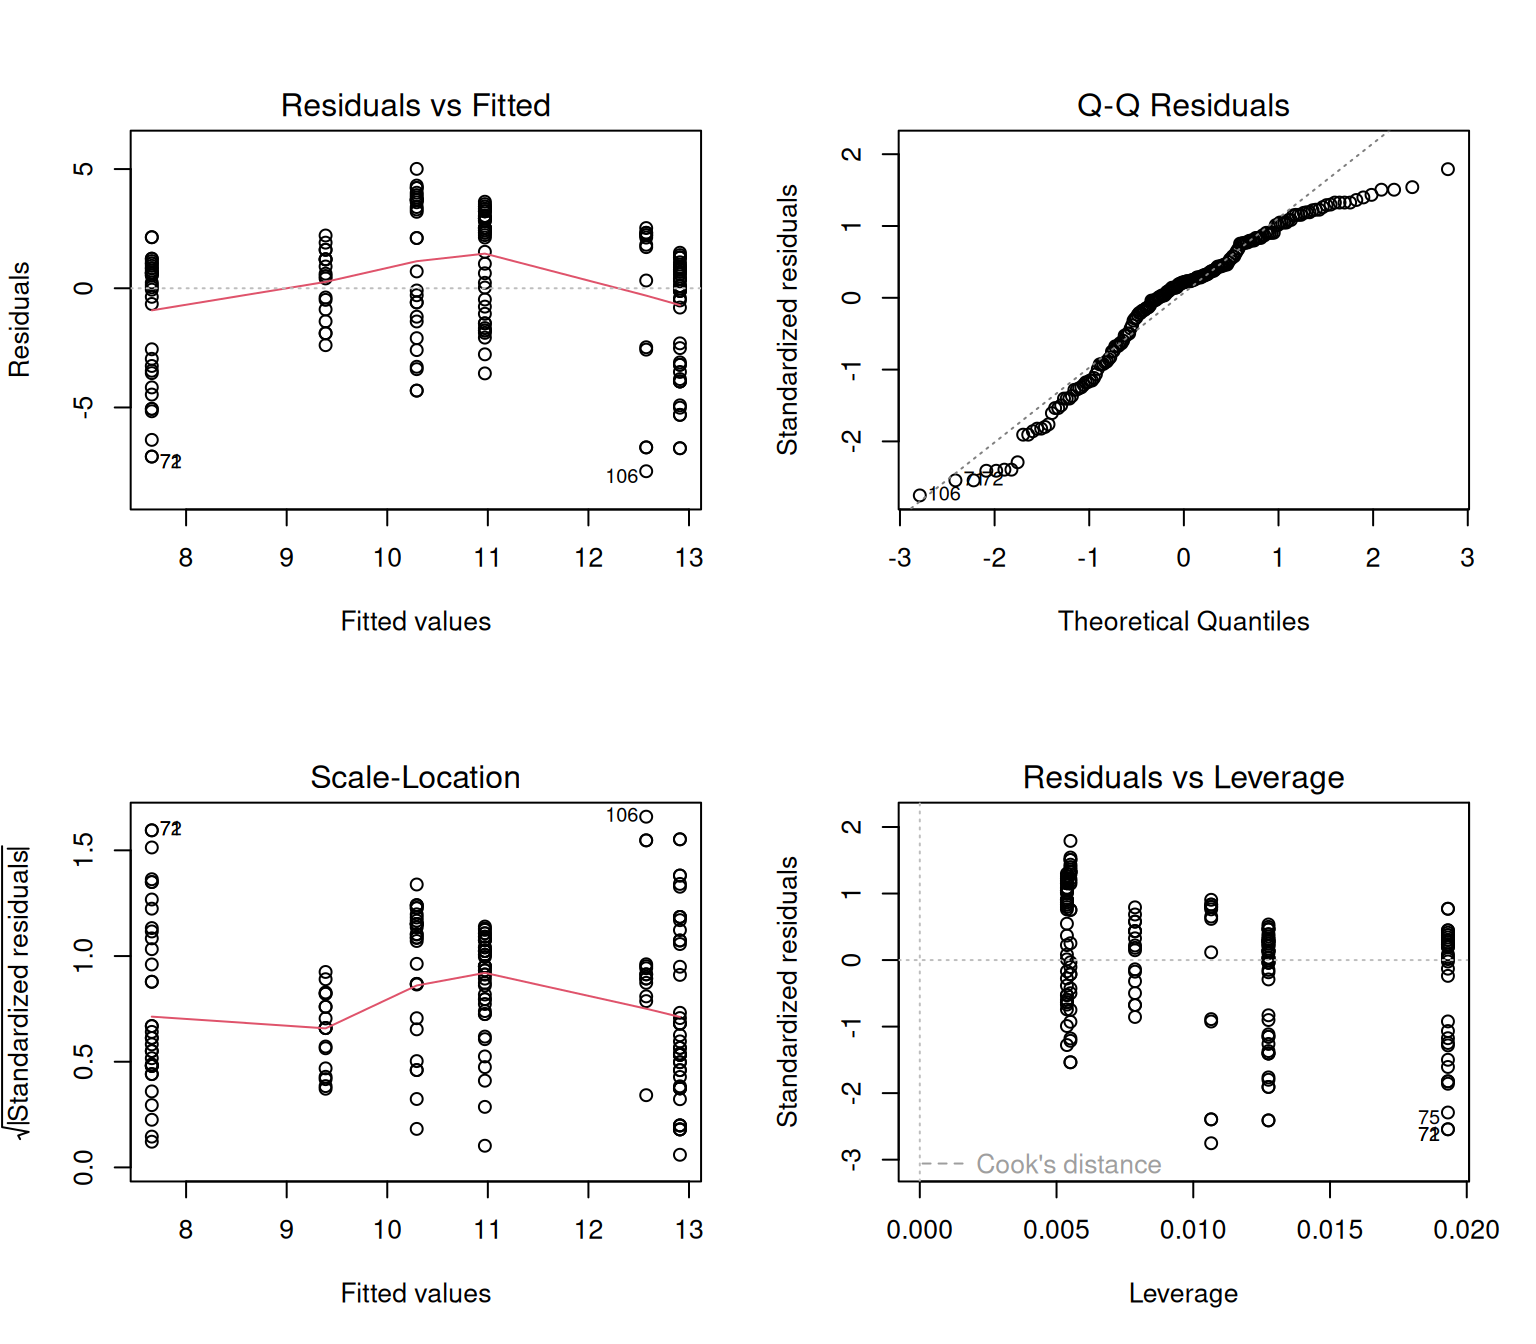
plot.lm.
O que cada painel responde:
| Painel | Pergunta |
|---|---|
| Residuals vs Fitted | a relação é mesmo linear? |
| Q-Q Residuals | os resíduos são aproximadamente normais? |
| Scale-Location | a variância é constante ao longo do ajuste? |
| Residuals vs Leverage | algum ponto sozinho está puxando a reta? |
As faixas verticais nos dois primeiros painéis são o desenho amostral aparecendo de novo: seis altitudes, seis valores ajustados possíveis.
broom: o resultado como data frame
tidy(m1, conf.int = TRUE)# A tibble: 2 × 7
term estimate std.error statistic p.value conf.low conf.high
<chr> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl>
1 (Intercept) 7.54 0.400 18.8 3.85e-45 6.75 8.33
2 altitude 0.00336 0.000367 9.14 1.03e-16 0.00263 0.00408glance(m1)# A tibble: 1 × 12
r.squared adj.r.squared sigma statistic p.value df logLik AIC BIC
<dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl>
1 0.308 0.304 2.80 83.5 1.03e-16 1 -464. 935. 945.
# ℹ 3 more variables: deviance <dbl>, df.residual <int>, nobs <int>summary() imprime na tela e acabou. tidy() devolve um data frame — que entra em ggplot, em kable, em dplyr. É a diferença entre um resultado que você lê e um resultado que você usa.
tidy(m1, conf.int = TRUE) %>%
  filter(term != "(Intercept)") %>%
  ggplot(aes(estimate, term)) +
  geom_vline(xintercept = 0, linetype = 2) +
  geom_pointrange(aes(xmin = conf.low, xmax = conf.high)) +
  labs(x = "Estimativa (°C por metro)", y = NULL)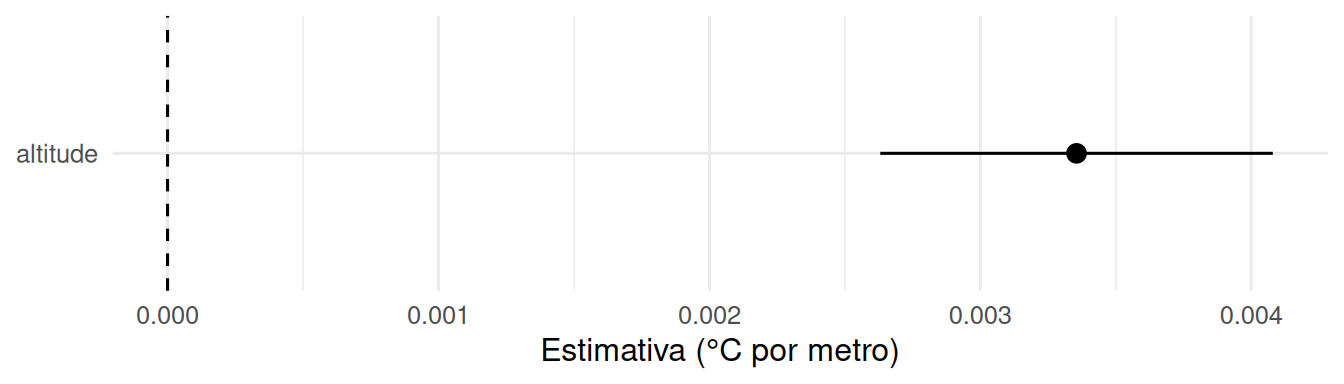
Uma preditora categórica
m2 <- lm(tol_aquec ~ especie, data = anuros)
anova(m2)
Analysis of Variance Table
Response: tol_aquec
Df Sum Sq Mean Sq F value Pr(>F)
especie 4 1089.0 272.26 48.272 < 2.2e-16 ***
Residuals 185 1043.4 5.64
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1tidy(m2)# A tibble: 5 × 5
term estimate std.error statistic p.value
<chr> <dbl> <dbl> <dbl> <dbl>
1 (Intercept) 11.9 0.354 33.5 1.63e-80
2 especieDendropsophus minutus -5.12 0.506 -10.1 2.21e-19
3 especieLeptodactylus latrans -0.187 0.560 -0.333 7.39e- 1
4 especiePhysalaemus cuvieri -2.38 0.592 -4.02 8.62e- 5
5 especieRhinella icterica 1.32 0.495 2.67 8.15e- 3Cinco espécies, quatro coeficientes. O R tomou a primeira em ordem alfabética como referência, e cada linha é a diferença em relação a ela:
levels(anuros$especie)[1] "Boana faber" "Dendropsophus minutus" "Leptodactylus latrans"
[4] "Physalaemus cuvieri" "Rhinella icterica" Para trocar a referência: relevel(anuros$especie, ref = "Rhinella icterica"). A escolha não muda o ajuste — muda quais contrastes você lê de graça.
Juntando as duas
m3 <- lm(tol_aquec ~ altitude + especie, data = anuros)
glance(m3) %>% select(r.squared, adj.r.squared, nobs)
# A tibble: 1 × 3
r.squared adj.r.squared nobs
<dbl> <dbl> <int>
1 0.761 0.754 190anova(m1, m3)Analysis of Variance Table
Model 1: tol_aquec ~ altitude
Model 2: tol_aquec ~ altitude + especie
Res.Df RSS Df Sum of Sq F Pr(>F)
1 188 1476.70
2 184 510.13 4 966.57 87.159 < 2.2e-16 ***
---
Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1O salto no R² é grande, e o teste F entre os modelos é inequívoco: as espécies diferem muito entre si em tolerância. Faz sentido biológico — elas diferem em CTmax, em tamanho e em hábito.
O desenho amostral decidindo o que é possível
A pergunta natural agora: o efeito da altitude é o mesmo nas duas serras?
Antes de ajustar, olhe o desenho:
with(anuros, table(serra, altitude)) altitude
serra 35 550 820 1022 1500 1600
Serra da Mantiqueira 0 18 0 0 0 55
Serra do Mar 39 0 36 54 23 0Cada altitude pertence a uma única serra. Não existe um par de sítios na mesma altitude em serras diferentes. Altitude, entendida como identidade do sítio, está aninhada em serra — não cruzada com ela.
Escreva isso como modelo e o R avisa:
m4 <- lm(tol_aquec ~ alt_fator * serra, data = anuros)
summary(m4)$coefficients
Estimate Std. Error t value Pr(>|t|)
(Intercept) 6.441667 0.4309680 14.946974 1.372863e-33
alt_fator550 3.175000 0.7464584 4.253418 3.346699e-05
alt_fator820 5.138334 0.6392288 8.038333 1.071230e-13
alt_fator1022 5.903788 0.5811171 10.159378 1.568829e-19
alt_fator1500 5.529762 0.8144529 6.789542 1.501290e-10
alt_fator1600 5.406250 0.5701170 9.482702 1.281698e-17A tabela termina em alt_fator1600: nenhum termo de serra foi estimado. O R não conseguiu — e diz exatamente por quê:
alias(m4)Model :
tol_aquec ~ alt_fator * serra
Complete :
(Intercept) alt_fator550 alt_fator820
serraSerra do Mar 1 -1 0
alt_fator550:serraSerra do Mar 0 0 0
alt_fator820:serraSerra do Mar 0 0 1
alt_fator1022:serraSerra do Mar 0 0 0
alt_fator1500:serraSerra do Mar 0 0 0
alt_fator1600:serraSerra do Mar 0 0 0
alt_fator1022 alt_fator1500 alt_fator1600
serraSerra do Mar 0 0 -1
alt_fator550:serraSerra do Mar 0 0 0
alt_fator820:serraSerra do Mar 0 0 0
alt_fator1022:serraSerra do Mar 1 0 0
alt_fator1500:serraSerra do Mar 0 1 0
alt_fator1600:serraSerra do Mar 0 0 0 Cada termo de serra é combinação linear dos termos de altitude. Os dois rótulos descrevem a mesma partição dos dados.
ImportanteIsto não é um erro
Não é bug do R, não é amostra pequena, não é problema de convergência. É o desenho amostral impondo um limite: nenhum dado no mundo, coletado assim, separa “efeito de altitude” de “efeito de serra”.
O mesmo modelo, com altitude contínua
m5 <- lm(tol_aquec ~ altitude * serra, data = anuros)
tidy(m5)
# A tibble: 4 × 5
term estimate std.error statistic p.value
<chr> <dbl> <dbl> <dbl> <dbl>
1 (Intercept) 8.45 0.984 8.59 3.57e-15
2 altitude 0.00212 0.000706 3.01 2.96e- 3
3 serraSerra do Mar -1.64 1.08 -1.53 1.29e- 1
4 altitude:serraSerra do Mar 0.00273 0.000860 3.18 1.74e- 3Agora ajusta. Todos os coeficientes estimados, a interação até é “significativa”. O que mudou?
O dado não mudou. Mudou a premissa: tratar altitude como número impõe que a resposta seja uma reta dentro de cada serra. Com isso, duas altitudes por serra já bastam para estimar duas retas, e a diferença entre elas vira a interação.
Essa premissa tem preço. As faixas amostradas não são as mesmas:
tapply(anuros$altitude, anuros$serra, range)$`Serra da Mantiqueira`
[1] 550 1600
$`Serra do Mar`
[1] 35 1500O coeficiente serraSerra do Mar é a diferença entre as serras em altitude = 0 m — fora da faixa amostrada em ambas, e a 550 m do ponto mais baixo da Mantiqueira. É extrapolação sustentada pela reta, não pelo dado.
Centralize a altitude e veja o que acontece:
anuros$alt_c <- anuros$altitude - 1000
m6 <- lm(tol_aquec ~ alt_c * serra, data = anuros)
tidy(m6)
# A tibble: 4 × 5
term estimate std.error statistic p.value
<chr> <dbl> <dbl> <dbl> <dbl>
1 (Intercept) 10.6 0.397 26.6 2.55e-65
2 alt_c 0.00213 0.000706 3.01 2.96e- 3
3 serraSerra do Mar 1.09 0.482 2.27 2.46e- 2
4 alt_c:serraSerra do Mar 0.00273 0.000860 3.18 1.74e- 3| modelo | estimate | std.error | p.value |
|---|---|---|---|
| altitude crua (contraste a 0 m) | -1.642 | 1.077 | 0.129 |
| altitude centrada (contraste a 1000 m) | 1.092 | 0.482 | 0.025 |
R², resíduos e graus de liberdade são idênticos nos dois: é o mesmo ajuste. Mas o coeficiente de serra mudou de sinal e de conclusão.
Nenhum dos dois está errado. Eles respondem a perguntas diferentes — “a 0 m” e “a 1000 m” — e só o segundo cai dentro da faixa amostrada.
ImportanteA lição
Um coeficiente sem a pergunta junto não significa nada. “O efeito da serra” não é uma quantidade única que o modelo estima: é o contraste em um ponto que você escolheu, muitas vezes sem perceber que estava escolhendo.
Uma segunda opinião sobre as premissas
Os quatro painéis do plot() pedem que você julgue olhando. O pacote performance, do ecossistema easystats, faz o teste e devolve um veredito escrito.
library(performance)

check_normality(m3)
OK: residuals appear as normally distributed (p = 0.230).check_heteroscedasticity(m3)Warning: Heteroscedasticity (non-constant error variance) detected (p < .001).Os dois discordam: a normalidade dos resíduos passa, a homocedasticidade não. Antes de “consertar” qualquer coisa, três perguntas:
ImportanteUm teste não decide por você — ele te obriga a ter um argumento
- Quanto foi violado? Um p pequeno com n = 190 detecta desvios que talvez não importem. Volte ao Scale–Location e olhe.
- O que isso estraga? Heterocedasticidade não enviesa os coeficientes. Ela estraga os erros-padrão — e portanto os p e os intervalos.
- Era de se esperar? Este modelo junta cinco espécies que diferem em massa por duas ordens de grandeza. Variância constante seria surpreendente.
check_collinearity(m3)# Check for Multicollinearity
Low Correlation
Term VIF VIF 95% CI adj. VIF Tolerance Tolerance 95% CI
altitude 1.06 [1.01, 1.73] 1.03 0.94 [0.58, 0.99]
especie 1.06 [1.01, 1.73] 1.01 0.94 [0.58, 0.99]r2(m3)# R2 for Linear Regression
R2: 0.761
adj. R2: 0.754VIF baixo: altitude e espécie não estão medindo a mesma coisa, o que já sabíamos pelo desenho — as cinco espécies ocorrem nas duas serras.
O painel completo
# fig-height >= 5 e obrigatorio: abaixo disso os seis paineis nao cabem,
# o grid desiste e o knitr descarta a figura SEM erro e SEM aviso.
# Medido em setembro de 2026; nao baixe este numero.
plot(check_model(m3))
For confidence bands, please install `qqplotr`.Ignoring unknown labels:
• size : ""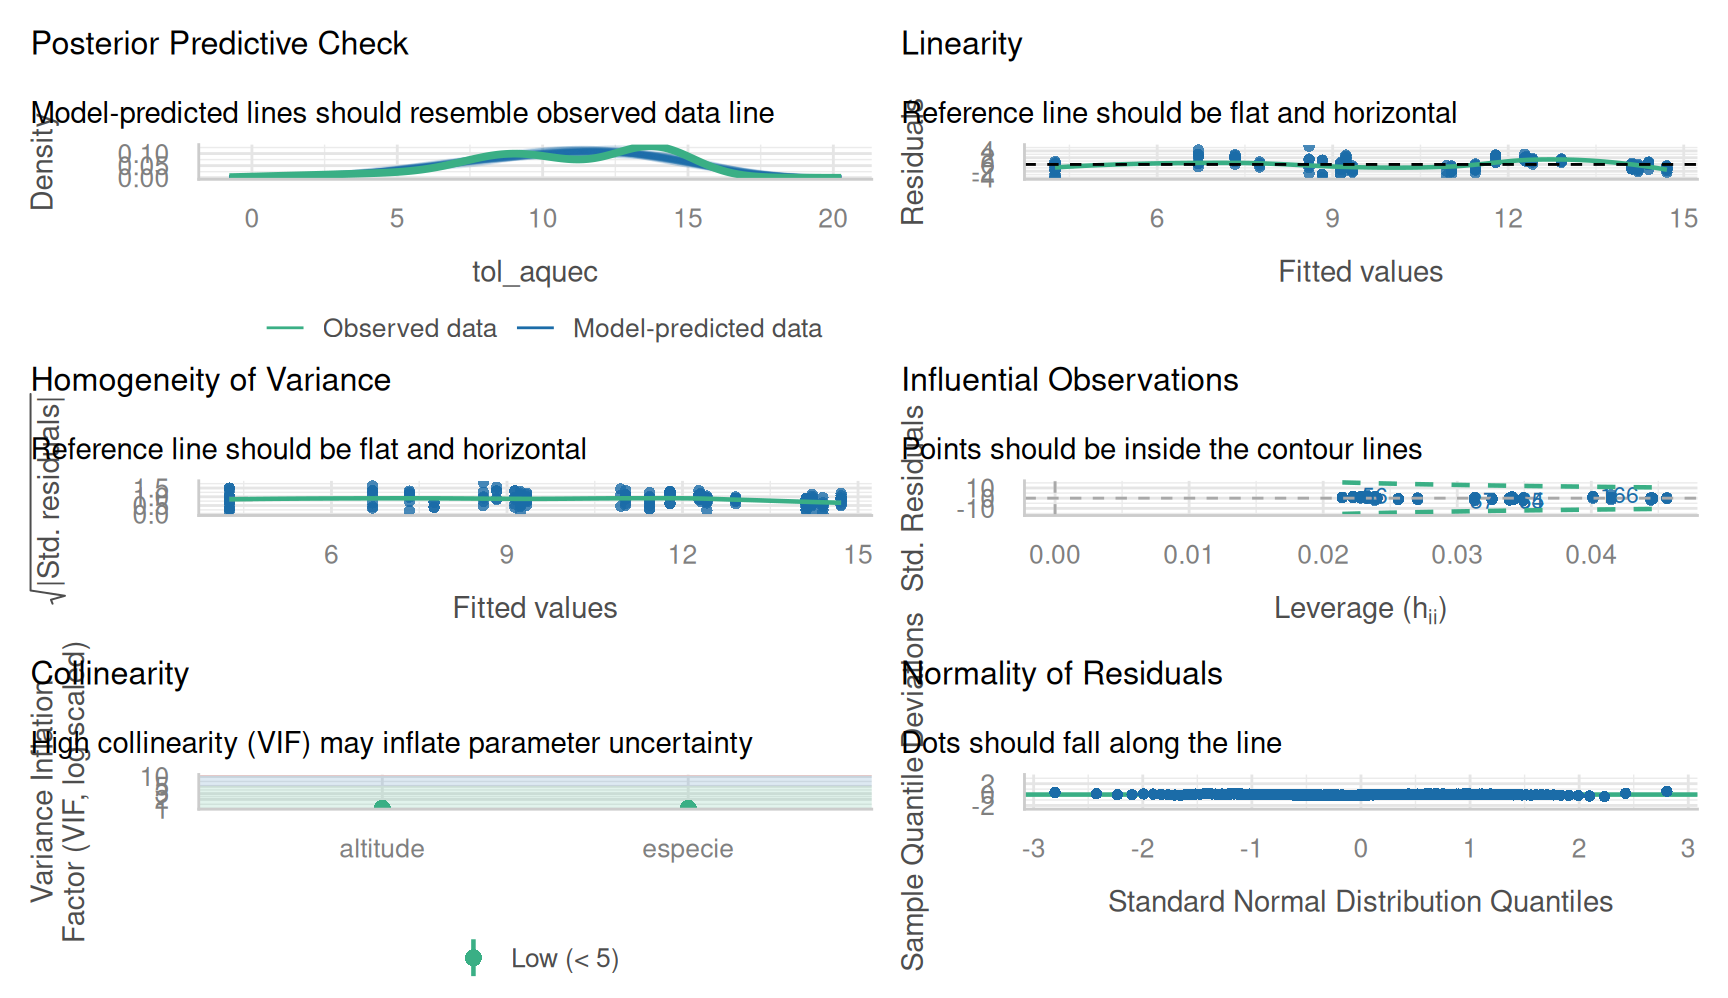
m3. As faixas sombreadas são intervalos de referência simulados: o que se espera ver se a premissa valer.
As faixas de referência são o que torna este painel mais fácil de ler que o plot() do R base: em vez de perguntar “isso parece um padrão?”, você pergunta “isso saiu da faixa?”.
AvisoA armadilha que custou uma tarde
check_model() com fig-height menor que 5 não desenha nada e não reclama. O documento compila, a figura não está lá. Se o seu .qmd tiver warning: false, nem o aviso que explicaria isso chega até você.
É por isso que o comentário sobre a altura está dentro do bloco: para que ninguém — inclusive você, daqui a seis meses — “limpe” aquele número.
O que dá para fazer: um modelo por serra
É por isso que o artigo original analisa as duas serras separadamente.
por_serra <- anuros %>%
  filter(!is.na(tol_aquec)) %>%
  group_by(serra) %>%
  group_modify(~ tidy(lm(tol_aquec ~ altitude, data = .x), conf.int = TRUE)) %>%
  ungroup() %>%
  filter(term == "altitude")
por_serra
# A tibble: 2 × 8
serra term estimate std.error statistic p.value conf.low conf.high
<fct> <chr> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl>
1 Serra da Manti… alti… 0.00212 0.000579 3.67 4.97e- 4 0.000968 0.00328
2 Serra do Mar alti… 0.00486 0.000533 9.12 1.88e-15 0.00380 0.00591ggplot(anuros, aes(altitude, tol_aquec, colour = serra)) +
geom_point(alpha = .5) +
geom_smooth(method = "lm", formula = y ~ x) +
labs(x = "Altitude (m)", y = "Tolerância ao aquecimento (°C)", colour = NULL) +
theme(legend.position = "top")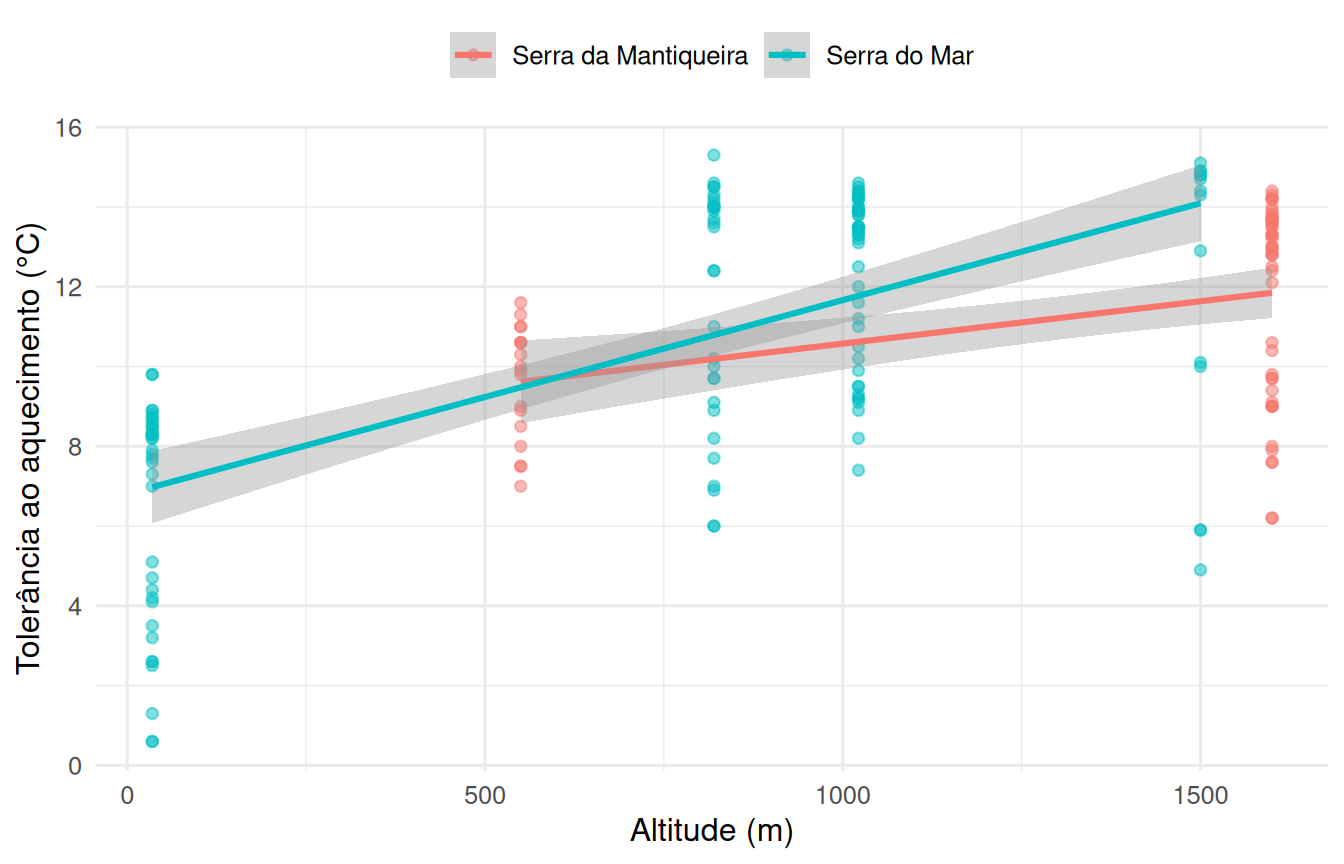
Olhe a reta da Mantiqueira: ela liga duas altitudes, 550 e 1600 m. O modelo roda, o p-valor sai pequeno, o intervalo de confiança é estreito — e mesmo assim não há como saber se a relação entre elas é reta, curva ou degrau. A da Serra do Mar, com quatro altitudes, ao menos permite olhar.
Saber a diferença entre “o modelo rodou” e “a inferência se sustenta” é metade desta disciplina.
Exercício
- Refaça o modelo
m1usandoctmaxcomo resposta em vez detol_aquec. O sinal do coeficiente muda? Explique usando a definição detol_aquec. - Ajuste
ewl ~ massae olhe o diagnóstico. A relação pede transformação? Compare comlog(ewl) ~ log(massa). nobs(m1)contranrow(anuros): quantas observações o modelo usou de fato, e de onde veio a diferença?- Centralize a altitude em 550 m em vez de 1000 m e refaça
m6. O que acontece com o coeficiente de serra, e por quê?